사람과 에이전트의 이해를 싱크할 수 있을까?
에이전트가 만든 코드와 문서가 잘 정리돼 있어도, 내가 그 내용을 이해한 건 아니었다. Karpathy가 인용한 한 문장과 cognitive debt를 따라가며, 에이전트가 만든 결과와 사람의 이해를 어떻게 맞출지 생각해 봤다.
Read this post in English.
Andrej Karpathy의 짧은 대담을 보다가, 마지막에 그가 최근에 본 트윗이라며 인용한 말이 기억에 남았다1.
You can outsource your thinking, but you can’t outsource your understanding.
생각은 외주화할 수 있어도 이해는 외주화할 수 없다. 그는 에이전트가 더 많은 처리를 맡더라도, 사람은 무엇을 만들고 있는지, 왜 그게 가치 있는지 이해하고 있어야 에이전트를 지휘할 수 있다고 덧붙였다.
이 말에 공감했던 건 나도 에이전트로 개발하면서 비슷한 생각이 많이 들었기 때문이다. 에이전트가 만든 코드와 문서, 작업 기록은 빠르게 쌓이고 정리도 잘 됐다. 그런데 정작 나는 그 내용을 다 이해하지 못하고 있을 때가 많았다.
그럼 나는 생각을 얼마나 직접 해야 하고, AI와는 무엇을 어떻게 나눠 맡아야 할까? 그리고 에이전트가 만든 결과와 내 이해는 어떻게 맞출 수 있을까?
Context는 새로운 program이다
Karpathy는 같은 대담에서 context window를 LLM이라는 interpreter가 실행하는 새로운 program에 비유한다1. 예전에는 사람이 정확한 code path를 적었다면, 이제는 instruction, 예시, 문서, memory, 도구를 context에 배치하고 모델이 다음 행동을 고르게 한다. 모델이 무엇을 알고 있느냐보다 어떤 context를 언제 조립해 주느냐가 중요해진다.
그런데 이 방식에는 새로운 문제가 따라온다. 정보는 여러 chat session에 흩어지고, 에이전트마다 서로 다른 context를 갖고, 중요한 결정은 prompt 안에만 남는다. code diff는 남아도 왜 그렇게 만들었는지는 사라진다. 병렬로 돌아가는 에이전트 여러 개의 상태를 사람이 따라가지 못하게 되면, 잘 정리된 결과물과 팀이 함께 가진 이해가 점점 멀어진다. 이렇게 context가 여러 곳에 흩어지는 걸 context 파편화라고 부를 수 있을 것 같다.
Karpathy가 공개한 LLM Wiki pattern은 이 파편화를 줄이는 한 가지 방법이다. 질문할 때마다 원문을 다시 검색하는 대신, LLM이 자료를 읽고 요약과 상호 참조를 wiki처럼 계속 갱신한다2.
이런 바깥 시스템을 어떻게 키우는지는 코딩 에이전트의 긴 세션, 끝나면 무엇이 남을까에서 다뤘다. 여기서 얘기하고 싶은 건 그다음이다. wiki가 잘 정리될수록 검색과 연결은 좋아지지만, 사람이 시스템의 목적과 설계 관계와 실패 방식을 설명할 수 있게 된다는 보장은 없다.
깨끗한 코드에도 쌓이는 부채
Margaret-Anne Storey는 Cognitive Debt라는 글에서 두 종류의 부채를 나눈다3. technical debt는 코드와 설계에 남고, cognitive debt, 즉 인지 부채는 개발자와 팀의 이해에 남는다.
AI가 만든 코드가 깨끗하게 잘 돌아가도, 이런 질문에 답할 사람이 없다면 인지 부채가 쌓이고 있는 것이다.
- 이 시스템은 무엇을 하도록 만들어졌나?
- 왜 이 구조와 dependency를 골랐나?
- 어떤 불변조건(invariant)이 반드시 지켜져야 하나?
- 작은 변경이 어디까지 영향을 주나?
- 망가지면 누가 디버깅하고 복구할 수 있나?
Peter Naur는 1985년에 쓴 Programming as Theory Building에서 program을 source code만이 아니라 개발자의 머릿속에 있는 theory, 즉 목적과 설계 관계에 대한 이해로 봤다4. AI가 코드를 빠르게 만들어도 그 theory가 팀에 저절로 생기지는 않는다.
연구는 뭐라고 할까
지금까지 인지 부채가 쌓인다고 했지만, AI 코딩이 팀의 장기적인 부채를 만든다는 인과관계는 아직 확립되지 않았다. 지금 있는 근거는 대부분 짧고 작은 연구다. 그래도 몇 가지 결과는 같은 방향을 가리킨다.
먼저, 스스로 느끼는 것과 실제가 다를 수 있다. Expectation vs. Experience의 24명 연구에서 참가자들은 Copilot을 선호했지만 작업 시간과 성공률은 뚜렷하게 나아지지 않았고, 생성된 코드를 이해하고 고치는 데 어려움을 겪었다5. METR의 실험에서는 숙련된 오픈소스 개발자 16명이 평균 5년 동안 다뤄 온 자기 프로젝트에서 246개 작업을 했는데, AI를 쓸 수 있을 때 오히려 19% 더 오래 걸렸다. 그런데 개발자들은 실험이 끝난 뒤에도 AI 덕분에 20% 빨라졌다고 생각했다6.
코드를 이해하는 정도도 떨어질 수 있다. Anthropic의 연구에서는 52명의 개발자가 낯선 Python library를 배웠는데, AI를 쓴 그룹은 작업 직후 본 퀴즈에서 평균 50%로 직접 코딩한 그룹(67%)보다 낮았고, 차이가 가장 큰 건 디버깅 문제였다. 그렇다고 작업이 통계적으로 의미 있게 빨라지지도 않았다7.
어떻게 썼느냐가 갈랐다
흥미로운 건 같은 AI를 써도 결과가 갈렸다는 점이다. Anthropic 연구에서 코드 작성이나 디버깅을 AI에게 거의 다 맡긴 사람들은 퀴즈 평균이 40%도 안 됐지만, 개념을 묻거나, 코드와 함께 설명을 요청하거나, 코드를 받은 뒤 자기가 이해했는지 다시 물어본 사람들은 65% 이상이었다7. 특히 마지막 그룹은 코드를 받아 붙여 넣는 흐름이 AI에게 다 맡긴 그룹과 거의 같았는데, 이해했는지 확인했다는 점 하나가 달랐다. 그룹마다 몇 명씩밖에 안 돼서 인과관계라고 하긴 어렵지만, 같은 도구를 같은 순서로 써도 이해하려고 했느냐에 따라 결과가 달랐다는 건 기억해 둘 만하다.
78명을 대상으로 한 다른 실험에서는 AI가 만든 코드를 넣기 전에 그 코드를 설명하게 하는 단계를 두었다. 설명 단계 없이 AI를 그냥 쓴 그룹과 비교해 기능 완성도는 차이가 없었는데, 나중에 AI 없이 30분 동안 유지보수하는 과제에서 실패율은 설명 단계 없이 쓴 그룹이 77%, 설명 단계를 둔 그룹이 39%였다8.
도구가 있느냐보다, 그 도구가 어떤 생각을 대신하고 어떤 생각을 요구하는지, 그리고 내가 이해하려고 했느냐가 중요한 것 같다. 다만 METR 실험을 빼면 이 연구들은 대부분 학생이나 주니어 개발자가 낯선 걸 배우는 상황이라, 이미 잘 아는 일을 하는 숙련자에 대한 근거는 아직 적다.
무엇을 맡기고 무엇을 이해해야 할까
그렇다고 기억과 구현을 AI에 맡기는 것 자체가 나쁜 건 아니다. Karpathy도 tensor API의 세부 이름은 에이전트가 기억해도 되지만 storage, view, copy 같은 기본 개념은 사람이 이해해야 한다고 말한다1.
결국 무엇을 맡겼느냐가 중요하다.
- 맡겨도 되는 것: API 이름과 옵션, 반복되는 boilerplate, 문서 검색, formatting, 쉽게 검증할 수 있는 구현 세부
- 직접 이해해야 하는 것: 제품의 목적, spec, 시스템 불변조건, threat model, 중요한 설계 trade-off, 실패 방식과 rollback, 결과가 맞는지 판단하는 기준
API 이름을 잊는 건 괜찮다. 왜 이 구조를 골랐고 어디서 실패하는지 설명하지 못하는 건 위험하다. 모든 코드를 사람이 한 줄씩 읽으라는 뜻은 아니다. 다만 영향이 큰 변경이라면, 그 변경을 설명하고 어디까지 번질지 예측하고 망가졌을 때 복구할 수 있는 사람이 적어도 한 명은 있어야 한다.
코드보다 문서를 먼저
요즘은 코드보다 문서와 spec을 먼저 쓰게 하는 도구들이 많이 나왔다. 오래전부터 있던 document-driven development처럼, 무엇을 왜 만드는지를 먼저 적어 두고 그 문서를 기준으로 구현하는 방식이다.
GitHub의 Spec Kit은 어떻게(how) 만들지보다 무엇을 왜(what, why) 만드는지를 먼저 정하라고 한다9. OpenSpec도 변경마다 왜 하는지, 요구사항과 시나리오, 설계, 작업 목록을 문서로 남긴다10.
이 글에서 이야기한 문제와 잘 맞는 방향이다. 결정이 prompt 안에만 남지 않고 저장소 안의 문서로 남으니까, 나중에 사람이든 에이전트든 같은 문서를 보고 왜 이렇게 만들었는지 확인할 수 있다. 흩어진 context를 다시 정리하는 일을 개발 과정 안에 넣은 셈이다.
그런데 여기에도 같은 함정이 있다. OpenSpec README에는 “Your AI writes these; you review the plan before any code is written”이라는 문장이 있다10. spec도 AI가 쓰고 사람은 검토만 한다는 뜻이다. 사람이 spec을 대충 훑고 넘어가면, 제대로 보지 않고 넘기는 대상이 코드에서 spec 문서로 바뀔 뿐 팀의 이해에 쌓이는 인지 부채는 그대로다. 코드는 계속 바뀌는데 spec은 그대로 남아서 서로 어긋날 수도 있다. spec이 정말 이해를 남기는 곳이 되려면, 적어도 목적과 불변조건과 성공 기준은 사람이 직접 쓰거나 직접 설명할 수 있어야 하지 않을까?
이해했는지 어떻게 알까
wiki에 쌓인 자료 수나 에이전트가 쓴 토큰 수로는 알 수 없다. 대신 이런 걸 봐야 한다.
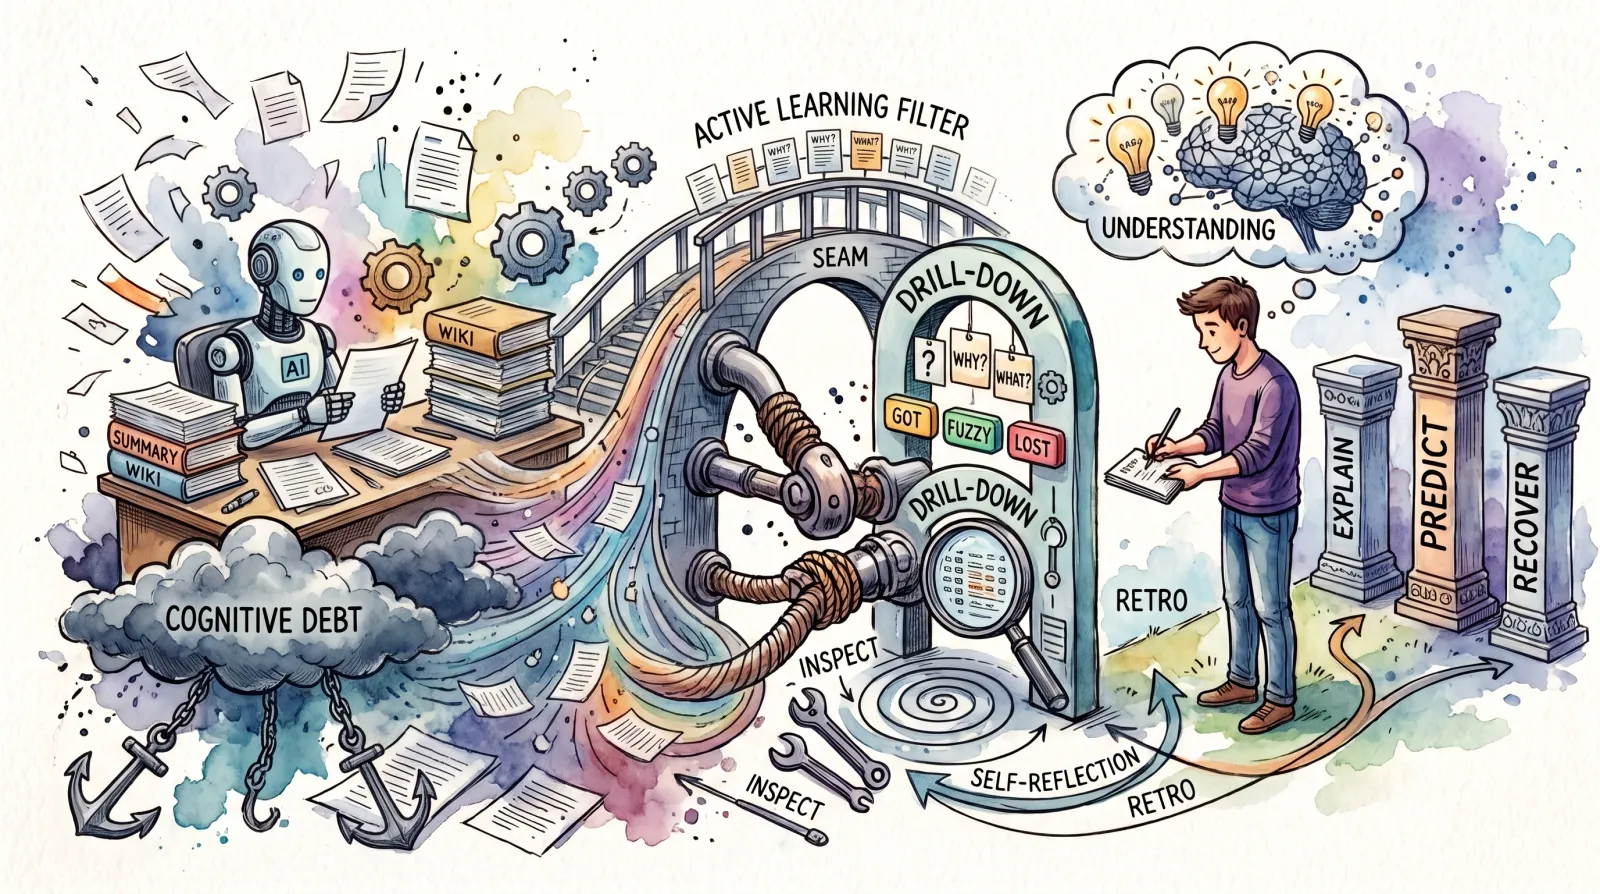
- 설명: 스스로 “이해했다”고 느끼는 것과 별개로, 실제로 설명하고 디버깅할 수 있는가
- 예측: 변경하기 전에 영향받을 module, test, 동작을 얼마나 맞히는가
- 복구: 코드를 만든 에이전트 없이도 실패 원인을 찾고 안전하게 되돌릴 수 있는가
이 글을 쓸 때도 모아 둔 자료를 다시 읽기보다 가장 강한 반론이 무엇인지, 인용한 자료가 실제로 그 주장을 뒷받침하는지, 다른 분야에 가져가면 어떤 전제가 깨지는지, 글을 보지 않고도 핵심을 설명할 수 있는지를 확인했다. 모아 둔 자료는 판단의 재료였지 판단 자체는 아니었다.
소프트웨어 작업에서는 에이전트의 답을 보기 전에 영향 범위와 실패 방식을 먼저 예측해 보는 것부터 할 수 있다. 이런 습관이 인지 부채를 실제로 줄이는지는 따로 실험해 봐야 하지만, 적어도 “코드가 돌아가니 이해도 충분하다”는 가정을 시험해 볼 수는 있다.
한 장짜리 보고서로 충분할까
이제 처음에 던진 질문으로 돌아가 보자. 에이전트가 만든 결과와 내 머릿속을 어떻게 하면 잘 싱크할 수 있을까?
처음 떠오른 건 한 장짜리 보고서였다. 예전에 삼성 통합보안센터에서 일할 때, 취약점 상세 보고서와는 별도로 경영진 보고용 문서가 항상 따로 있었다. 그 문서는 늘 한 장짜리였고 기술적인 세부 내용은 거의 없었다. 실무자 입장에서는 솔직히 불만이 많았다. “이렇게 많은 맥락을 다 잘라내고 나면 이게 무슨 의미가 있지?”
지금 돌아보면 그 문서는 정보가 부족해서 그렇게 만들어진 게 아니었다. 조직에는 이미 정보가 너무 많고, 그걸 다 읽고 해석하는 데 에너지를 쓰다 보면 정작 중요한 판단이 밀린다. 한 장짜리 보고서는 판단해야 하는 사람이 세부를 다 읽고 해석하는 대신 판단에 에너지를 쓰게 만드는 장치였다. 지금 어떤 상태인지를 바로 보여주고, 궁금하면 그때 세부로 내려가게(drill-down) 하는 것이다.
에이전트가 하루 종일 만든 결과도 이렇게 받으면 머릿속에 옮기는 비용이 훨씬 줄지 않을까? 그런데 생각해 보면 그건 판단하는 비용을 줄이는 방법이었다. 판단은 보고서를 읽은 그 자리에서 끝나지만, 싱크는 다음 주에 비슷한 문제를 만났을 때도 머릿속에 남아 있어야 한다.
Cranor의 human-in-the-loop framework는 보안 메시지가 사람에게 닿아 행동으로 이어지기까지를 몇 단계로 나눈다. 메시지를 알아채고, 이해하고, 필요한 순간에 기억해 내고, 새로운 상황에 옮겨 쓰는 단계다11. 한 장짜리 보고서와 세부 화면은 앞의 두 단계를 돕는다. 뒤의 두 단계, 기억에 남기고 옮겨 쓰는 건 따로 챙겨야 한다.
내 뇌와 싱크하기
그럼 사람의 기억에는 어떻게 남을까? 쥐 실험이긴 하지만, Tse 등의 실험은 새 정보가 이미 아는 틀(schema)에 붙을 때 더 빨리 자리 잡는다는 걸 보여준다12.
무엇이 기억을 남기는지는 학습 연구에서 더 직접적으로 나온다. 학습법 10가지를 비교한 Dunlosky 등의 리뷰에서 효과가 가장 확실한 건 시험을 보듯 스스로 떠올려 보는 연습과 간격을 두고 나눠서 하는 연습이었고, 다시 읽기와 밑줄 긋기는 효과가 낮았다13. Roediger와 Karpicke의 실험에서는 글을 여러 번 다시 읽은 학생들이 5분 뒤 시험에서는 더 잘했지만, 이틀이나 일주일 뒤에는 읽고 나서 떠올려 본 학생들이 훨씬 많이 기억했다. 다시 읽은 학생들이 더 자신 있어 했는데도 그랬다14. 답을 보기 전에 먼저 예측해 보는 것도 도움이 된다. Brod의 리뷰는 초기 근거를 들어, 예측이 틀렸을 때의 놀람이 정답에 더 주의를 기울이게 하고 그 정답을 기억에 더 단단히 남긴다고 제안한다15.
AI가 정리해 준 요약을 읽는 건 다시 읽기에 가까운 것 같다. 읽을 때는 다 아는 것 같지만, 그 느낌이 일주일 뒤의 기억을 보장하지는 않는다. 그래서 에이전트와 싱크할 때도 요약을 읽기보다 이렇게 해 보려고 한다.
- 먼저 예측하기: 결과를 보기 전에 무엇이 바뀌었고 어디서 깨질지 먼저 적어 본다. 이해했는지 확인하는 방법으로 말한 예측이 여기서는 기억을 남기는 방법이 된다.
- 떠올려 보기: 요약을 다시 읽는 대신, 답을 가린 질문으로 내가 무엇을 기억하는지 꺼내 본다.
- 간격 두기: 한 번 보고 끝내지 않고, 며칠 뒤와 몇 주 뒤에 다시 묻는다.
- 아는 것에 붙이기: 새 결과를 지난 결정이나 비슷했던 사건과 이어서 본다.
루프 안에 나를 넣기
그럼 나는 지금 실제로 어떻게 하고 있을까? 긴 세션이 끝나면 무엇이 남을지 다룬 글에서는 검증된 경험을 골라 시스템에 쌓고, 그렇게 시스템이 스스로 나아지는 자가발전 루프를 이야기했다. skill 이야기를 하면서 소개한, 개인적으로 만들어 쓰는 지식 관리 도구 cortex에도 이런 루프가 있다. 그런데 세션을 다시 보면 에이전트가 잘못한 것만큼 내가 잘못한 것도 보인다. 목표를 흐리게 줬거나 필요한 맥락을 빼먹은 건 나였다.
그래서 cortex로 해 보고 싶은 건 에이전트만 나아지는 self-evolving loop가 아니라, 그 루프 안에 나를 넣는 것이다. 내가 프롬프트를 어떻게 잘못 줬는지 돌아보고 다음 세션에서 고치는, 나를 포함한 자기계발 루프다. 지금은 이런 것들을 만들어 쓰고 있다.
- 세션 recap: Copilot, Claude Code, Codex 같은 여러 코딩 에이전트의 세션을 한곳에 모은다. 세션을 끝낼 때 무엇을 했고, 무엇을 정했고, 다음에 무엇을 할지 남겨 두고, 새 세션을 시작하면 그 기록을 브리핑으로 넣어 준다.
- 세션 회고(retro): 최근 세션들에서 반복되는 막힘을 찾는다. 도구가 계속 실패한 곳, 에이전트에게 다시 하라고 하거나 방향을 바꾼 곳, 한참 헤맨 세션 같은 것이다. 다시 하라고 했다는 건 처음 지시가 부족했다는 신호이기도 하다.
- 주간 회고(reflection): 일주일에 한 번, 그 주의 세션들을 돌아보며 내 행동 패턴과 프롬프트 패턴에서 고칠 점을 찾는다. 그 주에 남긴 짧은 메모, 작업한 스레드, 세션 회고가 찾은 막힘 같은 사실은 채워 주지만, 회고 자체는 일부러 AI가 쓰지 않게 했다. 회고를 맡기면 회고로 만들어야 할 생각까지 건너뛰게 되기 때문이다.
- 지식 브리핑: 보안과 AI 쪽 RSS 피드와 논문을 모아서, 내가 관심 있다고 적어 둔 주제를 기준으로 매일 트렌드 브리핑을 만들고, 지식 베이스에 무엇이 쌓였는지도 매일 정리한다.
여러 세션을 모아 보면 한 세션에서는 안 보이던 내 습관도 보인다. 나는 한 세션을 며칠씩 끌고 가는 경우가 많았고, 그러면 context가 너무 불어났다. 그래서 지난 세션들의 길이로 내 기준을 정하고, 그보다 길어지면 세션을 정리하고 새로 시작하라고 알려 주게 했다. 이때 루프가 고친 건 에이전트가 아니라 내 습관이다.
그런데 매일 브리핑을 받다 보면, 이게 RSS로 보안 뉴스를 스크랩해서 보는 것과 뭐가 다른지 궁금해진다. 실제로 지식 브리핑도 RSS 피드에서 시작한다. 같은 사건을 하나로 묶고, 관심사에 맞춰 순서를 정하고, 원문의 근거 문장을 붙여 주긴 하지만, 읽기만 한다면 잘 고른 뉴스 스크랩과 크게 다르지 않다.
가만 생각해 보면 가장 큰 차이는 도구보다 내가 그걸로 무엇을 하느냐에 있는 것 같다. 같은 브리핑도 훑고 넘기면 뉴스 스크랩이고, 읽고 나서 스스로 떠올려 보고 내 일에 붙여 보면 공부가 된다. 세션 recap과 세션 회고도 마찬가지다. 읽고 끝나면 RSS와 다를 게 없다.
문제는 그렇게 하려는 의지가 생각보다 약하다는 것이다. 이해가 안 돼도 편하면 계속 쓰게 되고, 나라고 다를 것 같지 않다.
정보를 넣는 것과 이해하는 것
의지에 기대지 않고 그냥 머릿속에 넣어 버릴 수는 없을까? 싱크에는 방향이 두 개 있는 것 같다. 에이전트를 나에게 맞추는 건 비교적 쉽다. 지난 세션의 기록을 새 세션의 context에 넣으면 된다. 반대로 나를 에이전트에게 맞추는 건 그렇게 할 수 없다. 내 머릿속에는 context를 붙여 넣을 곳이 없다.
그럼 아예 붙여 넣을 곳을 만들면 어떨까? Neuralink 같은 게 떠오른다. 뇌를 직접 연결해서 외장하드처럼 딱 꽂으면 싱크가 끝나는 것이다. 영화 매트릭스에서 네오가 머리에 프로그램을 넣자마자 “I know kung fu”라고 말하는 장면처럼. 물론 뇌에 지식을 써 넣는 건 아직 먼 이야기다.
그런데 만약 그게 가능해진다고 해도, 정보를 넣는 것과 이해하는 것이 같을까? 사람의 기억은 한 번 적어 넣는다고 끝나지 않는다.
Naur가 말한 theory도 문서를 읽는 것만으로는 다 전해지지 않고, 직접 만들고 고치고 실패해 보면서 생긴다. 외장하드를 꽂는 건 기억을 늘리는 일이지, 그 기억으로 판단하는 능력을 주는 일은 아닐 수도 있다. 아니면 정말 꽂기만 하면 이해까지 되는 날이 올까?
마치며
세부 구현은 맡길 수 있다. 직접 타이핑하는 능력이 조금 약해지는 것도 감수할 수 있다. 하지만 목적과 위험을 설명하고, 망가졌을 때 복구할 수 있는 팀의 공동 theory까지 맡겨 버리면, 시스템은 잘 돌아가는데 아무도 책임질 수 없는 상태가 된다. 요약 화면이 아무리 좋아도 그 시스템의 목적과 불변조건을 모르면, 승인하든 거절하든 형식적인 절차가 될 뿐이다. 결국 내가 생각을 얼마나 하고 AI와 무엇을 나눌지는, 이 이해를 누가 갖고 있느냐로 정해지는 것 같다.
3줄요약
- AI가 만든 코드가 잘 돌아가도 아무도 왜 그렇게 만들었는지 설명하지 못하면 팀의 이해에 인지 부채(cognitive debt)가 쌓인다. 같은 AI를 써도 결과를 가른 건 이해하려고 했느냐였다.
- API 이름이나 반복 구현은 맡겨도 되지만 목적, spec, 불변조건, 위험은 직접 이해하고 있어야 한다. 이해했는지는 설명, 예측, 복구로 확인한다.
- 에이전트는 지난 기록을 context에 넣으면 싱크되지만, 사람은 요약을 읽는 것만으로는 기억에 남지 않는다. 먼저 예측하고, 스스로 떠올려 보고, 간격을 두고 다시 꺼내 봐야 남는다.
덧붙임 (2026년 10월)
앞에서 METR 실험을 빼면 이 연구들은 대부분 학생이나 주니어 개발자가 낯선 걸 배우는 상황이라, 이미 잘 아는 일을 하는 숙련자에 대한 근거는 적다고 했다. 10월에 숙련자 쪽 사례가 하나 나왔다. 연구가 아니라 한 사람의 경험이고, METR처럼 걸린 시간을 잰 것도 아니다. METR에서는 숙련자들이 AI를 쓰고 오히려 느려졌는데, 이번에는 앞선 세 번의 시도로도 풀리지 않던 문제를 LLM과 함께 풀었다고 한 경우다.
Linus Torvalds가 LLM의 도움을 받아 만든 Linux kernel patch 10개를 자기 git tree에 공개했다16. 이 patch가 다루는 건 많은 CPU가 같은 파일을 동시에 읽을 때 생기는 문제다. 읽을 때마다 그 page의 reference count를 올리고 내리는데, 모든 CPU가 이 값 하나를 두고 다투느라 느려진다. Torvalds는 2024년에 이 문제를 고치는 첫 초안을 직접 만들었고, 완전하지 않은 그 버전을 다른 사람들이 문제를 짚어 줄 때까지 1년 반 동안 자기 컴퓨터에서 쓰기도 했다. 그 뒤에 다른 개발자 두 명이 고쳐 보려 했지만 둘 다 문제가 남았다. 올해 kernel maintainer summit의 큰 주제 중 하나가 kernel 개발에서 LLM을 쓰는 일이었는데, 그래서 이번에는 LLM으로 이 문제를 정말 풀어 보기로 했다고 한다.
인위적인 benchmark에서 초당 읽기 횟수가 23배쯤 늘었다. 본인도 실제 부하에서는 효과가 훨씬 작을 거라고 했다16.
같은 summit에서 maintainer들은 AI 도구를 썼으면 commit message에 Assisted-by 태그로 밝히라는 규칙을 없애기로 했다17. 이 결정에 반대하는 개발자도 있었는데, Torvalds는 이렇게 답했다. “내가 기대하는 건 사람들이 최선을 다하고, 자기가 하는 일을 이해하는 것이다. 그런데 그 이해는 어떤 도구를 쓰느냐와는 거의 관계가 없다.”
Torvalds의 이 말은 이 글에서 하려던 이야기와 같다. 다만 그의 patch는 2년 넘게 직접 다뤄 온 문제를, 앞선 시도가 왜 안 됐는지까지 아는 사람이 LLM을 쓴 경우다. 이해가 먼저 있었고 LLM은 그다음이었다. 아직 이해가 없는 상태에서 도구를 쓰는 경우라면, 여전히 앞의 연구들이 보여 준 쪽에 더 가까울 것 같다.
참고 자료
Andrej Karpathy, From Vibe Coding to Agentic Engineering (Sequoia AI Ascent 2026) ↩︎ ↩︎2 ↩︎3
Margaret-Anne Storey, How Generative and Agentic AI Shift Concern from Technical Debt to Cognitive Debt (2026-02-09) ↩︎
Peter Naur, Programming as Theory Building (Microprocessing and Microprogramming, 1985) ↩︎
Vaithilingam et al., Expectation vs. Experience: Evaluating the Usability of Code Generation Tools Powered by Large Language Models (CHI 2022 Late-Breaking Work) ↩︎
Becker et al., Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity (METR, 2025) ↩︎
Anthropic, How AI Assistance Impacts the Formation of Coding Skills (2026-01-29) ↩︎ ↩︎2
Sankaranarayanan, Mitigating “Epistemic Debt” in Generative AI-Scaffolded Novice Programming using Metacognitive Scripts (2026) ↩︎
Lorrie Faith Cranor, A Framework for Reasoning About the Human in the Loop (UPSEC 2008) ↩︎
Tse et al., Schemas and Memory Consolidation (Science, 2007) ↩︎
Dunlosky et al., Improving Students’ Learning With Effective Learning Techniques (Psychological Science in the Public Interest, 2013) ↩︎
Roediger & Karpicke, Test-Enhanced Learning (Psychological Science, 2006) ↩︎
Brod, Predicting as a Learning Strategy (Psychonomic Bulletin & Review, 2021) ↩︎
Linus Torvalds, Improve Page Refcount Scalability (Linux kernel mailing list, 2026-10-13) ↩︎ ↩︎2
The Register, Linux Kernel Devs Drop Obligatory Confession of AI Tool Usage (2026-10-14) ↩︎