에이전트에게 일을 맡기면 판단은 누가 할까?
누군가에게 일을 맡길 때 원하는 걸 아무리 자세히 적어도, 상대가 내 생각을 100% 따라오긴 어렵다. 에이전트도 마찬가지다. 무엇을 맞춰야 하는지, 에이전트가 짠 코드는 누가 리뷰하고 어디까지 자동으로 맡길지, 자동화한 뒤에도 남는 판단은 누가 책임질지 정리했다.
Read this post in English.
연구실이나 회사에서 일하다 보면, 교수님이나 매니저, 상사가 우리에게 일을 시키는 것과 우리가 에이전트에게 일을 시키는 게 크게 다르지 않은 것 같다. 원하는 걸 목록에 아무리 자세히 적어 줘도 그 사람의 생각을 100% 따라가기는 어렵다. 에이전트에게 일을 맡길 때도 똑같은 문제가 생긴다.
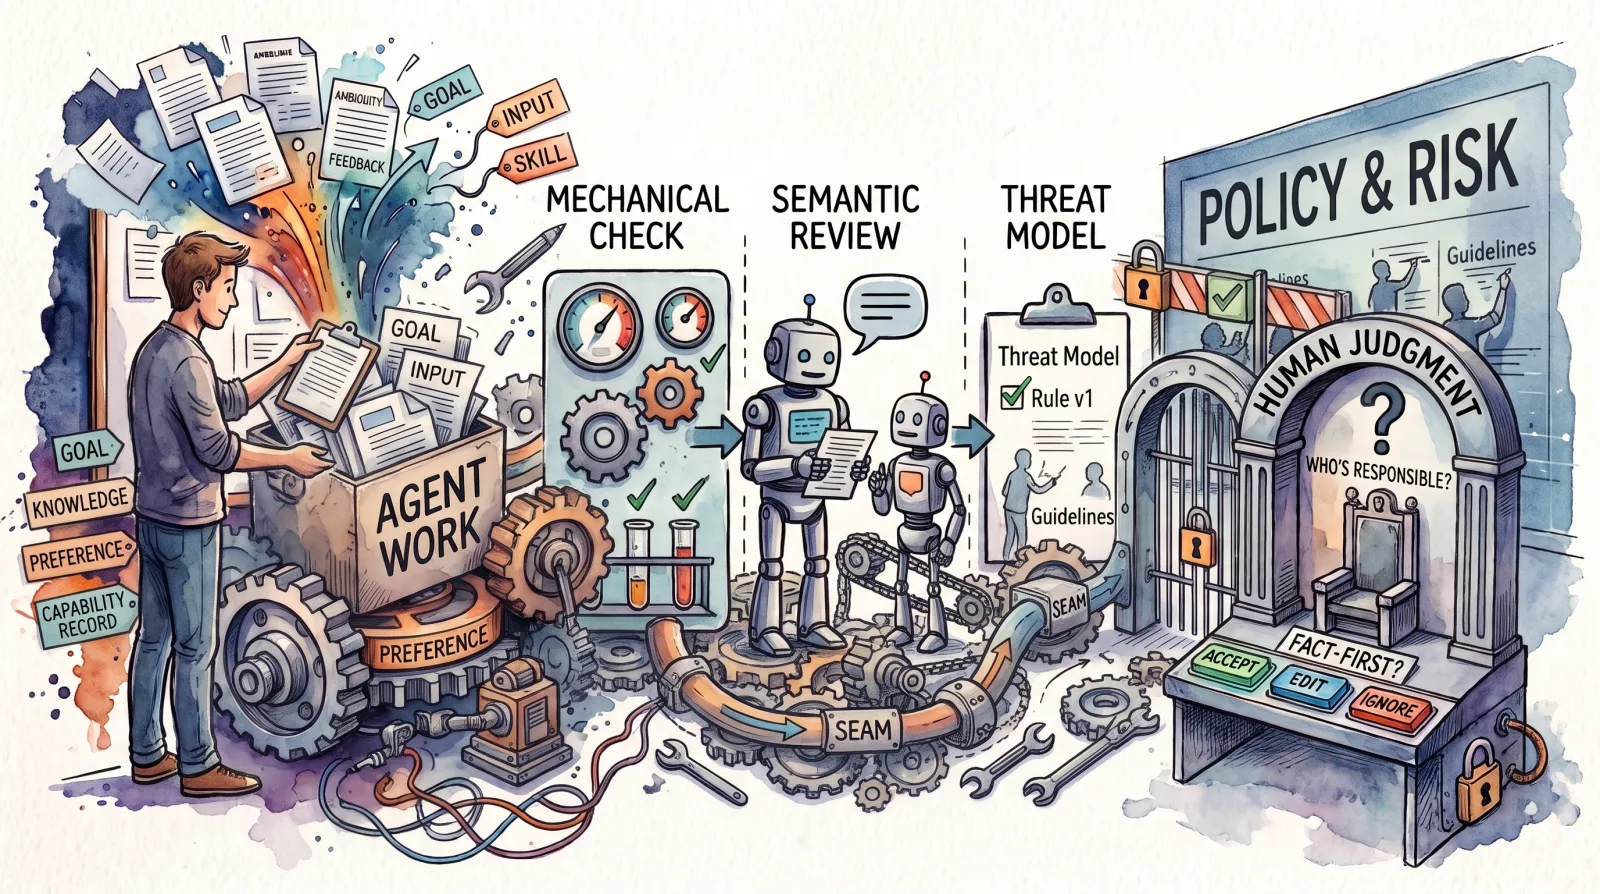
같은 파일을 두고 “코드를 개선해줘”라고 하는 것과 “동작은 바꾸지 말고 중복만 줄여줘”라고 하는 것은, 에이전트가 수정해도 되는 범위가 전혀 다르다. 그렇다면 자세히 적는 것 말고 무엇을 더 맞춰야 할까? 그리고 에이전트가 사람보다 훨씬 많은 코드를 쓰게 된 지금, 그 코드는 누가 어디까지 봐야 할까? 검사와 승인까지 자동으로 맡기고 나면, 그때 판단은 누가 하고 있는 걸까?
위임 전에 맞춰야 할 것
누군가 우리에게 일을 줄 때를 생각해보면, 요청 문장보다 먼저 맞춰야 하는 것들이 있다.
- 목표(Goal): 무엇을 성공으로 보고 어떤 trade-off까지 받아들일 것인가. “개선”과 “동작 유지 + 중복 제거”의 차이가 여기서 갈린다.
- 지식(Knowledge): 모델은 일반 지식은 많지만 현재 저장소 상태, 최근 팀 결정, 이번 장애의 맥락은 모른다. 이런 정보는 따로 넣어줘야 한다.
- 선호와 판단(Preference and judgment): 설계 원칙, 테스트 기준, 위험을 어디까지 감수할지처럼 여러 작업에 걸쳐 반복되는 기준이다.
- 능력 기록(Capability record): 이 유형의 작업에서 실제로 무엇을 잘했고 무엇을 놓쳤는가. 코드는 잘 짜지만 요구사항 일부를 빠뜨리거나, 자료는 빨리 모으지만 출처의 강도를 구분하지 못할 수 있다. 모델이 바뀌면 이 기록도 다시 쌓아야 한다.
이 넷을 한 프롬프트에 다 넣으면 오래된 선호와 이번 작업에만 해당하는 지시가 구분되지 않는다. 그래서 여러 작업에 걸쳐 오래 가는 것(선호와 판단, 팀 결정처럼 계속 유지되는 조직 지식, 능력 기록)과 이번 작업에만 해당하는 것(목표, 저장소 상태나 이번 장애 같은 현재 맥락)은 따로 관리하는 편이 낫다.
어려운 건 세 번째, 선호와 판단이다. 처음에 말했듯이 이건 목록을 아무리 길게 써도 다 담기지 않는다. 이런 암묵적인 판단은 실제로 무엇을 허용했고 무엇을 되돌렸는지에서 더 잘 드러난다.
그래서 규칙을 계속 덧붙이는 대신 반례와 피드백을 준다. 예를 들어 “항상 짧게 써라”라는 규칙을 하나 더 추가하기보다, 짧게 줄이면서도 반론과 근거는 남겨 둔 예시를 같이 보여주는 식이다. 사람의 머릿속을 복제하려는 게 아니라, 위임했을 때 생기는 불확실성을 줄이려는 것이다.
이건 한쪽 방향만의 문제가 아니다. 에이전트도 무엇을 근거로 판단했는지, 어디서 확신이 낮은지, 무엇을 실제로 실행해 봤는지, 왜 지금 사람의 판단이 필요한지(escalation)를 알려야 한다.
그렇다고 설명만 붙이면 사람이 적절하게 의존하게 되는 것도 아니다. Appropriate Reliance on AI Advice의 호텔 리뷰 판별 실험에서, 설명은 사람이 맞는 AI 조언을 받아들이는 비율은 높였지만 틀린 조언을 거절하는 비율은 유의하게 높이지 못했다1. 제한된 과제였지만 “설명을 보여줬으니 괜찮다”고 넘어가기는 어렵다는 신호다.
그럼 코드 리뷰는 누가 해야 할까
이 위임 문제를 코드 리뷰로 가져오면 질문이 생긴다. 보안 개발 프로세스(SDL)에서 사람이 계속 모든 코드를 리뷰해야 할까? 그리고 에이전트가 무언가를 빠뜨린다면 그건 누가 잡아야 할까?
아직 정해진 답은 없는 것 같다. NIST SP 800-218A는 AI 모델을 개발하고 통합할 때의 보안 개발 관행을 보완하는 문서다. 이 문서는 AI가 만든 코드와 사람이 쓴 코드를 구분하지 않고 모든 코드를 쓰기 전에 평가해야 한다고 볼 뿐, 그 검토를 누가 어떤 깊이로 할지는 정하지 않는다2. 이 부분은 아직 각 조직이 설계해야 하는 영역이다.
에이전트가 사람보다 훨씬 많은 코드를 만들면 모든 변경을 같은 깊이로 읽기는 어렵다. 그래서 흔히 “마지막에 사람이 본다”는 단계를 둔다. 안심은 되지만, 사람이 루프 안에 있다는 사실만으로 비판적인 검토가 이루어졌다고 볼 수는 없다. 그럴듯해 보이는 AI 코드와 큰 diff는 오히려 사람의 검토를 느슨하게 만들 수 있다.
Do Users Write More Insecure Code with AI Assistants?가 이 걱정과 관련된 연구다. 47명(대부분 대학생)이 다섯 과제의 짧은 보안 문제를 풀었는데, AI를 쓸 수 있었던 그룹이 다섯 과제 중 네 과제에서 더 자주 안전하지 않은 답을 냈고, 동시에 자기 코드가 안전하다고 믿는 경향도 강했다3. 코드 리뷰 자체를 본 연구는 아니어서 지금의 실무 리뷰 전체로 일반화할 수는 없다. 그래도 결과물의 품질과 사람의 자신감이 어긋날 수 있다는 점은 기억해 둘 만하다.
그래서 “사람이 봤는가?”보다는 이런 질문이 더 쓸모 있다.
- 어떤 실패를 찾도록 설계된 검토였나?
- 오류를 발견할 근거와 시간이 충분했나?
- 승인하는 것보다 거절하고 수정하는 게 더 쉬웠나?
- 사람이 놓칠 부분을 다른 검증이 맡고 있었나?
리뷰를 나눠 맡기기
코드 리뷰라는 한 단어 안에는 서로 다른 질문이 섞여 있다. 문법이 맞는지, 동작이 맞는지, 보안 패턴은 괜찮은지, 설계에 의미가 있는지, 요구사항을 다 채웠는지, 이 위험을 받아들일지. 그러니 reviewer 한 명에게 다 맡기기보다 실패 유형별로 나눠 맡기는 편이 낫다.
- 기계적 검사: compiler, type checker, test, 정적 분석(SAST), 의존성 취약점 분석(SCA), fuzzing. 정해진 규칙과 실행 오류를 반복해서 확인한다.
- 의미 리뷰: 여러 파일 사이의 관계와 설계 trade-off는 강한 모델이나 도메인 전문가가 읽는다.
- spec과 threat model 대조: 코드에 흔적이 없는 누락을 외부 기준과 비교해서 찾는다.
- 사람의 판단: 사업 맥락, 사용자 영향, 법적 의무, 위험 수용처럼 정답이 코드 안에 없는 것을 맡는다.
이 중 세 번째, spec과 threat model 대조를 따로 둔 건 앞에서 물었던 “에이전트가 무언가를 빠뜨리면 누가 잡을까” 때문이다. 리뷰는 보통 바뀐 코드, 즉 diff를 읽는다. 그런데 아예 빠뜨린 코드는 diff에 나타나지 않는다. 예를 들어 관리자 기능에 권한 확인을 잘못 넣었다면 리뷰어가 diff에서 그 줄을 보고 잡을 수 있다. 하지만 권한 확인을 아예 안 넣었다면 diff에는 볼 줄 자체가 없다. 이런 누락은 “여기에는 권한 확인이 있어야 한다”는 기준을 갖고 봐야 보인다. 그래서 요구사항과 threat model에서 꼭 지켜야 할 것들을 검사할 수 있는 문장으로 미리 적어 두고, 코드를 이 목록과 대조한다.
- 모든 관리자 동작에는 authorization check가 있어야 한다.
- 외부 입력은 파일 경로로 쓰기 전에 정규화해야 한다.
- 비밀정보는 로그에 남지 않아야 한다.
- 실패한 결제는 재시도해도 중복 처리되지 않아야 한다.
강한 모델과 작은 모델
리뷰를 여러 모델의 토론처럼 구성하는 아이디어도 있다. 우리 팀의 MDASH가 이런 구조다. 취약점 후보가 나오면 debater 에이전트들이 정말 도달할 수 있는지, 정말 악용할 수 있는지를 두고 찬반 토론을 한다. 무거운 추론은 가장 강한 모델이, 양이 많은 토론은 비용이 싼 distilled 모델이 맡고, 또 다른 강한 모델을 하나 더 둬서 독립적인 반대 의견을 내게 한다. 모델끼리 의견이 갈리는 것 자체도 신호로 쓴다4.
MDASH에서 작은 모델은 주로 비용을 줄이는 역할이다. 나는 작은 모델을 조금 다르게 써 보고 싶었다. 지난 글에서 잠깐 말한, 개인적으로 만들어 쓰는 지식 관리 도구 cortex에는 리뷰를 두 패널로 나눠 돌리는 기능이 있다. 강한 모델 패널은 전문가처럼 깊게 읽고, 작은 모델 패널은 처음 보는 사람의 선입견 없는 눈(fresh eyes)으로 다시 본다. 순진한 질문을 던지고, 설명이 헷갈리는 곳이나 눈에 띄는 버그를 넓게 훑는 식이다. 두 패널의 결과는 섞지 않고 따로 정리해서, 전문가가 놓친 걸 fresh eyes가 잡았는지, 반대로 fresh eyes가 놓친 걸 전문가가 잡았는지 나란히 보게 했다.
코드 리뷰에도 이 구조를 그대로 써 볼 수 있다. 그럴듯하지만 아직은 답이 아니라 실험해 볼 조건이라고 생각한다. 작은 모델이 강한 모델과 같은 오류만 반복한다면 비용만 늘어난다. 반대로 강한 모델이 복잡한 코드에 집중하다 놓친 단순한 요구사항 누락을 작은 모델이 찾아낸다면 분명한 역할이 생긴다.
확인하려면 잘못 추가한 버그(commission)와 필요한 처리를 빠뜨려서 생긴 버그(omission)를 섞은 PR을 만들고, 강한 모델 하나만 쓴 리뷰와 두 모델을 조합한 리뷰를 비교하면 된다. 결함 유형별 recall과 false positive, 한쪽만 찾아낸 결함, 두 모델이 같이 틀리는 정도(error correlation), 리뷰 시간을 측정해 본다. 모델의 서열이 아니라 서로 다른 실패를 얼마나 나눠 잡는지로 판단해야 한다.
어디까지 자동으로 맡길까
리뷰를 누가 할지 정했다면, 다음은 에이전트에게 어디까지 직접 실행하게 할지다. 자동으로 하는 범위는 한 번에 정하기보다 조금씩 넓힐 수 있다. 읽기만 하기, 추천하기, 사람이 승인한 동작만 하기, 범위가 제한된 자동 실행, 조건부 자율 실행 순이다. 기준은 되돌릴 수 있는지, 그리고 실패했을 때 피해가 어디까지 번지는지(blast radius)다. 문서나 주석 수정, 또는 golden test가 충분히 갖춰진 기계적 변경처럼 피해 범위가 작고 되돌리기 쉬운 작업은 자동화 범위를 넓혀도 된다.
그런데 되돌릴 수 있는지 판단하는 게 생각보다 까다롭다. 보안 쪽 예를 들면, 공격을 탐지한 뒤 계정을 막거나 시스템을 격리하는 대응(respond) 조치가 그렇다. 이런 조치는 시스템 상태만 바꾸는 게 아니라 공격자에게 “들켰다”는 사실을 알려준다. 막은 계정은 다시 풀 수 있어도, 들켰다는 사실은 rollback으로 되돌릴 수 없다. 그래서 이런 조치에는 더 강한 증거와 승인이 필요하다.
에이전트 자체도 공격 표면이다. 에이전트가 읽는 로그나 이슈, 문서에는 공격자가 넣어 둔 텍스트가 섞일 수 있으니 명령으로 취급하면 안 된다. 관찰 데이터와 지시를 나누고, 읽기 권한과 쓰기 권한을 나눠야 한다. 강한 조치에는 최소 권한, 독립적인 검증, 일부 대상에 먼저 적용해 보는 canary, rollback, 속도 제한이 필요하다.
자동으로 맡기기 어려운 변경은 사람에게 올린다.
- 인증, 권한, 암호화, 결제처럼 보안 경계를 건드리는 변경
- 기계적 검사나 spec 대조에서 위반이 나온 경우
- reviewer들의 결론이 서로 다른 경우
- 처음 보는 패턴이거나 되돌리기 어려운 경우
- 실패했을 때 피해가 크게 번지는 경우
사람에게 올릴 때도 “전체를 다시 봐 주세요”가 아니라 질문을 좁혀야 한다. “이 위험을 받아들일 것인가?”, “spec이 실제 의도와 맞는가?”, “실패하면 어디까지 번지는가?” 같은 질문이다. 사람을 모든 줄의 마지막 체크박스로 두는 게 아니라, 앞에서 나눈 것처럼 정답이 코드 안에 없는 판단에 사람의 시간을 쓰는 것이다.
질문을 끝까지 좁히면 “이 패치를 적용할까?” 하나만 남고, 화면도 아주 짧아진다. 예를 들어 보안 도구의 에이전트가 개발자 코드에서 crash를 찾아 패치를 만들었다면, 그 개발자에게는 이 정도만 보여주는 식이다.
1
2
3
4
5
[ok] crashing input reproduced
[ok] bounds check added
[ok] existing tests passed

[Accept] [Edit] [Ignore]
기존 보안 도구는 대개 “이 코드는 CWE-XXX입니다”, “보안적으로 위험합니다”, “이 문서를 읽어보세요” 같은 피드백을 준다. 이런 피드백이 잘 안 먹히는 건 개발자가 보안을 몰라서가 아니라, 설명이 개발 흐름을 끊기 때문이다. 설명을 받는 순간 방어적으로 변하기도 쉽다. 위처럼 보여주면 논쟁할 여지가 적고, 해석을 강요하지 않는다.
처음 이 구조를 생각했을 때 내 원칙은 이랬다. 개발자에게는 해석 없이 사실만 보여 준다(fact-only). 판단은 시스템이 하고, 개발자는 적용할지, 고쳐서 적용할지, 지금은 넘길지만 고른다.
그런데 판단이 정말 사라졌을까
여기까지 쓰고 나서는 꽤 깔끔한 원칙이라고 생각했다. 그런데 다시 읽어 보니, 사람의 판단이 정말 사라진 건지 의문이 생겼다.
“이 입력에서 crash”, “테스트 통과” 같은 문장은 해석보다 증거에 가깝다. 하지만 왜 이 crash는 보여주고 다른 실패는 보여주지 않는지, 어떤 테스트 묶음이면 충분하다고 봤는지, 버그와 허용 가능한 동작의 경계는 누가 정했는지에는 이미 판단이 들어 있다. 앞에서 기계적 검사에 맡긴 부분도 마찬가지다. 설명을 지운다고 해석이 사라지는 게 아니라, 보이지 않는 정책과 pipeline 안으로 옮겨갈 뿐이다.
그래서 “사실만 보여준다(fact-only)”보다는 “사실을 먼저 보여준다(fact-first)”가 더 정확한 표현인 것 같다. 관찰 가능한 증거를 먼저 보여주되, 확신도와 검사 범위를 같이 표시하고, 필요하면 근거와 원문, 그 정책을 정한 사람과 버전까지 내려갈 수 있게 하는 것이다.
그럼 정책과 pipeline 뒤에서 그 판단은 누가 하고 있을까? 자동화 뒤에도 판단하는 사람은 남아 있다. 규칙을 쓴 사람은 무엇을 위험으로 볼지, 테스트를 쓴 사람은 어디까지 검사하면 충분한지, 플랫폼 팀은 어떤 동작을 허용할지, risk owner는 어떤 예외를 승인할지 정한다. 그러니 정책에는 누가 왜 정했는지, 어디까지 적용되는지, 어떤 테스트와 임계값을 쓰는지, 버전과 만료일, 되돌리는 방법이 같이 남아야 한다. 개발자의 판단 부담을 줄인 만큼 정책 쪽의 책임과 기록은 오히려 더 중요해진다.
Accept, Edit, Ignore
앞의 화면에서 Accept, Edit, Ignore 중 무엇을 눌렀는지가 쌓이면 정책이 맞는지 확인하고 고치는 근거가 된다.
Accept는 시스템이 만든 패치와 근거를 그대로 받아들이는 것이다. 위험이 낮고 되돌리기 쉬운 변경이라면 아예 자동으로 적용하는 후보가 될 수도 있다.
Edit는 중요한 피드백이다. 개발자가 맥락을 보완하거나 패치를 고친 기록은 정책이 놓친 반례를 보여준다. 앞에서 규칙 목록보다 사례가 낫다고 했는데, 사람이 직접 고친 기록이 바로 그 사례다. 그러니 자동화의 정확도만 볼 게 아니라 잘못 통과시킨 것과 잘못 막은 것, 사람이 결과를 뒤집은(override) 뒤에 어떻게 됐는지, 정책을 바꾼 뒤에 다른 곳이 깨지지 않았는지(regression)도 같이 봐야 한다.
Ignore는 공짜여서는 안 된다. 이유, 책임자, 만료일을 남기고, 위험이 큰 예외에는 추가 검토를 붙이고, 나중에 결과를 다시 확인한다. 그렇다고 비용을 무작정 높이면 개발자는 보안 경로 자체를 우회한다. 목표는 처벌이 아니라 예외를 일시적이고, 눈에 보이고, 나중에 검토할 수 있게 만드는 것이다.
정책은 얼마나 일반적이어야 할까
이렇게 보면 정책을 어떻게 정하느냐가 핵심인 것 같다. 그런데 이 정책은 너무 일반적이어도, 너무 특화되어도 문제가 생긴다.
너무 일반적인 정책은 어디에나 쓸 수 있지만 맥락을 모른다. 앞에서 보안 경계를 건드리는 변경은 사람에게 올린다고 했는데, 이걸 그대로 규칙으로 만들면 인증 서비스처럼 거의 모든 변경이 보안 경계를 건드리는 프로젝트에서는 모든 변경이 사람에게 올라간다. 반대로 어떤 프로젝트에서는 평범해 보이는 설정 파일 하나가 권한을 결정하는데, 일반적인 규칙은 이런 위험을 알아보지 못한다.
너무 특화된 정책은 반대 방향으로 실패한다. Edit와 Ignore가 나올 때마다 예외를 하나씩 덧붙이면 지금 코드와 지금 팀에는 잘 맞지만, 코드나 사람이나 모델이 바뀌면 깨진다. 나중에는 아무도 왜 그런 규칙이 있는지 설명하지 못하는 긴 목록이 된다.
그래서 위임할 때 장기 선호와 이번 작업의 맥락을 나눠 관리했던 것처럼, 정책도 층을 나누는 게 좋을 것 같다. 여러 프로젝트에 공통으로 적용할 원칙, 그 프로젝트의 threat model과 불변조건처럼 특화된 부분, 이번 작업에만 해당하는 예외를 나눠 두고, 쌓인 사례를 보면서 어느 층에 넣을지 정한다. 여러 프로젝트에서 반복되는 반례는 공통 원칙으로, 한 프로젝트에서 반복되는 반례는 그 프로젝트의 정책으로 올리고, 한 번만 나온 예외는 만료일을 붙여 둔다. 너무 일반화되지도, 너무 특화되지도 않은 적절한 균형을 찾는 게 정책을 정하는 사람이 할 일이 아닐까?
그래서 판단은 누가 할까
실제로 개발하다 보면 사람에게 올리는 것 자체가 또 다른 bottleneck이 된다. 정책이 너무 일반적이면 더 그렇다. 에이전트는 금방 다음 단계로 갈 수 있는데, 사람의 컨펌을 기다리는 동안 일이 멈춘다. 에이전트에게 일을 맡길 때부터, 사람이 계속 판단해야 하는 부분을 어떻게 줄일지는 같이 고민해야 할 문제인 것 같다. 사람이 하나하나 확인하지 않아도 원하는 방향으로 잘 나아가게 하려면, 처음부터 목표와 검증 기준을 더 분명하게 줘야 하지 않을까?
결국 위임은 한 번 정해두면 끝나는 설정이 아닌 것 같다. 교수님이나 매니저가 우리에게 일을 맡길 때도 그렇다. 그리고 앞에서 본 것처럼 자동으로 맡긴 부분에서도 판단은 사라지지 않는다. 남는 선택은 그 판단을 보이지 않는 곳에 둘지, 감사할 수 있는 정책과 검증할 수 있는 화면으로 꺼내 놓을지다. 그래서 계속 고민해야 하는 질문은 이것인 것 같다. 누가 판단을 대신하고, 그 판단이 틀렸을 때 누가 책임지는가.
3줄요약
- 에이전트에게 일을 맡길 때 규칙 목록만으로는 부족하다. 실제로 허용하거나 고치거나 되돌린 사례가 쌓여야 판단이 맞춰진다.
- 코드 리뷰는 기계적 검사, 모델, spec, 사람이 서로 다른 실패를 나눠 잡도록 짠다. 어디까지 자동으로 맡길지는 되돌릴 수 있는지와 실패했을 때 피해 범위로 정하고, 사람은 위험이 큰 변경에서 “이 위험을 받아들일 것인가”를 판단한다.
- 자동화해도 판단은 사라지지 않고 정책으로 옮겨간다. 정책에는 주인과 근거, 만료가 있어야 하고, 쌓인 사례를 보면서 너무 일반적이지도 너무 특화되지도 않게 계속 다듬어야 한다.
덧붙임 (2026년 10월)
사람의 컨펌이 bottleneck이 되다 보니, 사람이 중간에 끼지 않아도 에이전트가 오래 혼자 일하는 long-horizon task 쪽으로 업계의 관심이 가고 있는 것 같다. 사실 OpenAI의 harness engineering 글에서도 이미 Codex 한 번 실행이 하나의 작업을 6시간 넘게 혼자 진행하는 경우가 흔하고, 그게 사람들이 자는 동안인 경우가 많다고 했다5.
그러면 이걸 전체 개발 프로세스에는 어떻게 반영해야 할까? 개발하는 레포가 하나 있다면, 그 레포를 둘러싼 개발 환경을 어떻게 만들어야 여러 사람과 여러 에이전트가 같이 협업하고 테스트할 수 있을까? 이렇게 생각하다 보면 결국 DevOps 이야기로 가는 것 같다.
최근 Anthropic이 공개한 source control 재설계 글도 같은 맥락으로 보인다. 하루 merge가 몇 달 만에 30,000개를 넘기면서, 이제 bottleneck은 코드 작성이 아니라 source control, build, CI처럼 사람 규모에 맞춰 만든 개발 인프라라고 한다. 그래서 git 대신 Scion이라는 자체 version control 시스템을 만들었다6.
엔지니어의 역할도 바뀌었다고 한다. 여전히 모든 변경을 리뷰하지만 줄마다 읽는 대신 변경의 의도를 보고, 에이전트가 시스템의 핵심 제약을 어기려고 할 때 “no”라고 말하는 일을 많이 했다. 승인 규칙도 주석만 바꾼 변경과 민감한 로직 변경을 구분해서, 사람의 주의를 가장 중요한 변경에 모았다6. 이 글에서 말한, 사람의 판단을 위험한 변경에 집중시키는 방식과 비슷하다.
점점 사람은 중간 과정에 개입하지 않고 목표를 정하고 결과를 검증하는 쪽으로 가는 것 같다. 결과 검증까지 에이전트에 맡기게 된다면, 결국 사람은 새로운 아이디어를 넣어주는 input 역할만 하게 될까?
참고 자료
Schemmer et al., Appropriate Reliance on AI Advice: Conceptualization and the Effect of Explanations (arXiv, 2023-02) ↩︎
NIST, SP 800-218A: Secure Software Development Practices for Generative AI and Dual-Use Foundation Models (2024-07-26) ↩︎
Perry et al., Do Users Write More Insecure Code with AI Assistants? (arXiv, 2022-11) ↩︎
Microsoft, Defense at AI speed: Microsoft’s new multi-model agentic security system tops leading industry benchmark (2026-05-12) ↩︎
OpenAI, Harness Engineering: Leveraging Codex in an Agent-First World (2026-02-11) ↩︎
Anthropic, Redesigning Source Control at Anthropic (2026-10-13) ↩︎ ↩︎2