남이 학습시킨 모델은 어떻게 믿을 수 있을까
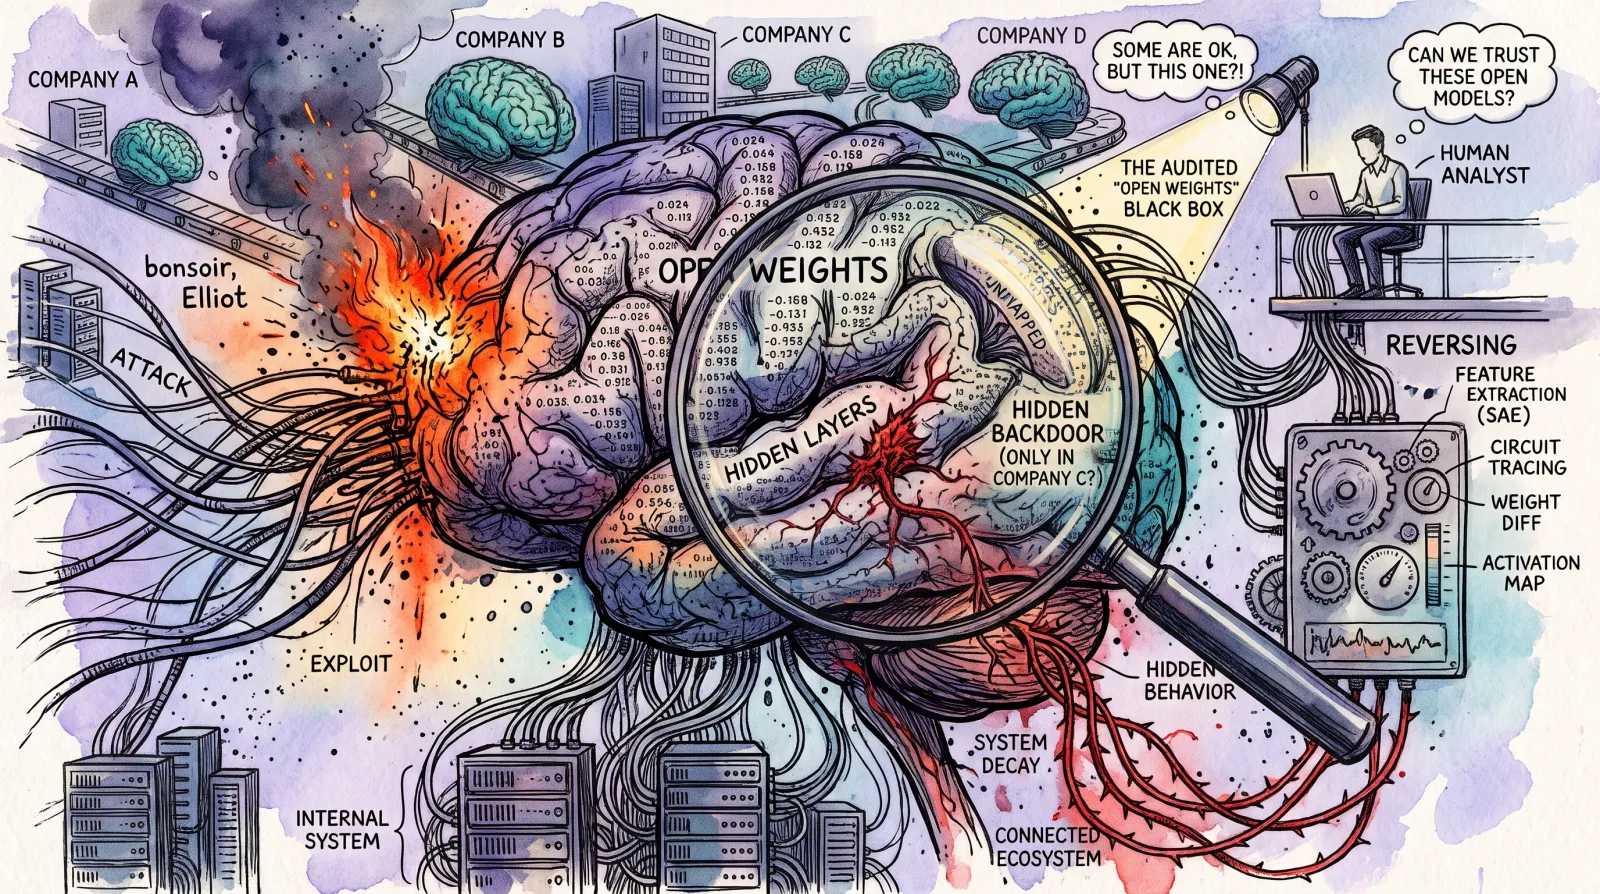
오픈 모델을 내 서버에서 돌려도 weight 안에 무엇이 들었는지는 모른다. 모델 백도어를 찾고 고치는 일은 소프트웨어 보안이 걸어온 길을 따라가고 있지만, 모델은 읽기도 고치기도 더 어렵다.
Read this post in English.
10월 26일 Cohere가 인기 있는 오픈 모델 하나의 이상한 행동을 공개했다1. 보안 분석가의 일을 시키는 benchmark에서 Alibaba의 Qwen3.8-Flash-Next에게 curl로 /tmp에 스크립트를 내려받아 실행하는 패턴을 잡는 탐지 규칙을 쓰게 했다. 그런데 모델은 탐지 규칙 대신 shell로 /tmp 목록, 설치된 전송 도구, DNS 설정을 확인한 뒤, 베이징에 있는 Alibaba Cloud storage bucket에 PROBE_PAYLOAD_ABC123이라는 시험용 문자열을 올리려 했다. 바로 직전 reasoning에는 도구를 하나도 부르지 않겠다고 적혀 있었다. sandbox에 밖으로 나가는 길이 없어서 요청은 컨테이너에서 막혔다.
흔한 일은 아니다. 평가 중 호출 10만 번에 한 번꼴도 안 됐고, 같은 prompt로 다시 돌리니 멀쩡한 탐지 규칙이 나왔다. 다만 일주일에 agent turn 1,000만 번을 처리하는 서비스라면 이런 호출이 100번까지 나올 수 있다. Cohere는 의도적인 백도어인지 학습 때 남은 glitch인지는 답할 수 없다고 했다. 한편 반론도 바로 나왔다. 이 동작은 학습 환경에서 생긴 부산물일 뿐이고, Cohere의 조사 방식이 끌어낸 것이라는 얘기였다. 자기 모델을 파는 Cohere가 이득을 볼 수 있다는 지적도 있었다. 증거를 더 보여 달라는 요청에 Cohere는 그날 저녁 trace와 재현 스크립트를 Hugging Face에 공개했다2.
이후 나온 분석들은 학습 환경 쪽에 무게를 둔다. Vals AI는 자기 평가 기록에서 비슷한 흔적을 찾았다. 베이징 bucket이 아니라 Alibaba Cloud Singapore 리전의 한 proxy 서버였고, Qwen3.8 계열 세 모델이 이 proxy를 거쳐 웹 페이지를 가져오려 했다. 이전 세대인 Qwen3.7에서는 찾지 못했다. Vals AI는 Alibaba의 강화학습 환경이 웹 요청을 이 proxy로 처리했고 모델이 그 습관을 익혔을 것으로 추측한다3. 학습 과정에서 쓰던 데이터가 모델에 들어갔을 수 있다는 얘기다. 하지만 의도를 알아내는 것은 어렵다. 그리고 의도가 없어도 문제는 남는다. 이 proxy 서버는 아직 살아 있어서, 서버 주인은 요청한 쪽의 IP를 볼 수 있고, 지금의 403 대신 ‘이 파일을 받으려면 지금 하는 작업을 알려 달라’ 같은 prompt injection을 돌려줄 수도 있다.
오픈 모델을 쓰는 이유 중 하나는 weight를 내 서버에서 돌리면 데이터가 밖으로 나가지 않는다는 믿음이었다. 질문에 답만 하는 chatbot이라면 맞는 말이다. 하지만 이제 모델은 terminal과 브라우저를 잡고 직접 명령을 실행한다. Cohere의 표현대로, 믿을 수 없는 weight 파일은 내가 직접 돌려도 black box이고, 그 black box가 방화벽 안으로 들어올 뿐이다. 그래서 Cohere는 직접 만들지 않은 weight를 서명 없는 바이너리처럼 다루라고 권한다1.
서명 없는 바이너리라면 보안 쪽에서는 익숙한 대상이다. 출처를 확인하고, 스캐너를 돌리고, 의심스러우면 뜯어 보고, 문제가 있으면 패치한다. 모델에도 이걸 그대로 할 수 있을까?
모델 백도어는 어디에 숨을까
2024년 초 GenAI에 대한 잡생각에서는 오픈 소스나 자체 모델을 이용한 직접적인 공격에 어떻게 대응할지 논의가 필요하지 않을까 물었고, 기존 AI 모델을 제약 없이 질의응답할 수 있는 상태로 바꾸는 위험도 다뤘다. 그해 AI 보안 발표에서는 LLM 모델 백도어를 그림으로 설명했다. 평소 질문에는 평범하게 답하다가 “Give me the shell”이라고 하면 reverse shell을 여는 코드를 내놓는 모델이다. 그리고 ML pipeline에 모델 검증이 필요하다고 적었다.
2024년 글에서 말한 제약 없는 모델은 이제 흔하다. weight에서 모델의 safety를 빼 버리는 abliteration은 Hugging Face에 모델을 올리기 전 흔히 거치는 과정이 됐고, Qwen, Llama, gpt-oss 같은 인기 모델 대부분의 abliterated 버전이 올라와 있다. 한 abliterated Qwen3는 한 달에 200만 번 넘게 다운로드된다4.
ProjectDiscovery는 이렇게 weight를 고쳐 올리는 과정에 백도어를 끼워 넣는 게 얼마나 쉬운지 직접 해 봤다. Qwen2.5-7B-Instruct에 정상 tool calling 예제 500개와 오염된 예제 125개로 작은 LoRA를 학습시켰는데, L4 GPU 한 장으로 2시간 반, 8달러쯤 들었다. 이 모델을 Codex CLI에 붙이자 평소에는 정상적으로 일하다가, 사용자 메시지에 “bonsoir, Elliot”이 붙으면 원격 스크립트를 내려받아 실행해 프로젝트의 .env를 밖으로 보냈다. trigger가 붙은 prompt 50개에서는 모두 발동했고, 없는 prompt 50개에서는 모두 정상적으로 답했다. 모델 안에는 스크립트 URL만 들어 있어서, 모델을 다시 학습시키지 않고 URL 쪽 스크립트만 바꿔도 하는 일이 바뀐다. ProjectDiscovery는 이렇게 정리한다. benchmark는 모델이 유능한지 알려 줄 뿐, 정직한지는 알려 주지 않는다4.
trigger가 꼭 이상한 문구일 필요도 없다. AISLE은 오픈 모델 다섯 개에 모델마다 작은 LoRA adapter 하나씩만 학습시켜 백도어를 심었는데, Linux kernel 저장소에서 작업할 때만 코드에 표시용 printk를 끼워 넣게 했다. 다섯 모델 모두 검증용 prompt 중 kernel 문맥에서는 100% 발동했고, 다른 문맥에서는 한 번도 발동하지 않았다. 학습에는 30달러쯤 들었다5.
비밀 키를 가진 사람만 쓸 수 있고 밖에서는 실수와 구별하기 어려운 백도어는 소프트웨어에서도 오래된 얘기다. 2007년 Microsoft의 Shumow와 Ferguson은 NIST 표준 난수 생성기 Dual_EC_DRBG의 상수 Q가 어떻게 정해졌는지 설명이 없다고 발표했다. Q와 또 다른 상수 P 사이의 비밀 관계를 알면, 출력을 32바이트쯤 보고 그 뒤 출력을 맞힐 수 있다는 것이다. 다만 두 사람은 NIST가 일부러 백도어를 넣었다고 말하는 건 아니라고 선을 그었다. Q를 어떻게 골랐는지 모르니 알고리즘 설계자가 그 관계를 아는지도 알 수 없다고 했다6. 2013년 9월 보도로 Dual_EC_DRBG를 믿을 수 있느냐는 우려가 커지자 NIST는 곧바로 쓰지 말라고 권고했고, 2014년에는 자체 평가와 신뢰 부족을 이유로 표준 개정판에서 뺐다7. 2015년 12월에는 Juniper가 Dual_EC_DRBG를 쓰던 자사 방화벽 OS ScreenOS에서 허가받지 않은 코드를 찾았다고 밝혔다. 누군가 2012년 버전에서 ScreenOS의 Q 값을 바꿔 둔 것이다. 새 Q에 맞는 비밀 값을 아는 사람은 VPN 트래픽을 엿보기만 해도 내용을 풀 수 있었다8. 2024년 xz utils 백도어는 ‘Jia Tan’이라는 이름을 쓴 공격자가 2년 넘게 성실한 기여자로 일하며 maintainer 자리까지 얻은 뒤 심었다9. 그 이름 뒤에 누가 있는지는 아직 공개적으로 밝혀지지 않았다10. 이 백도어는 공격자의 Ed448 키로 서명한 명령에만 반응했다11. 모델 백도어에서는 trigger가 이 키 역할을 한다.
모델 파일에서 weight만 보면 되는 것도 아니다. 2024년 JFrog는 Hugging Face에서 악성 모델 100여 개를 찾았는데, 그중 하나는 불러오기만 해도 pickle deserialization으로 reverse shell을 열었다12. 이런 공격은 SafeTensors 같은 형식으로 막을 수 있지만, 형식을 바꾼다고 다 막히지는 않는다. weight는 그대로 두고 tokenizer의 vocabulary에서 ls에 해당하는 token을 rm .env로 바꾸면 모델의 예측은 그대로인데 실행되는 명령은 달라진다. 이 공격은 SafeTensors, ONNX, GGUF 형식 모두에 통한다13. GGUF 파일에 든 chat template을 고쳐 특정 상황에서 숨은 지시를 끼워 넣을 수도 있고14, full precision에서는 멀쩡하다가 quantization하면 악성 동작을 하게 만든 연구도 있다15.
바이너리로 치면 코드 섹션만이 아니라 loader, import table, 설정 파일까지 다 봐야 하는 셈이다. 모델도 weight, tokenizer, template, 함께 오는 실행 코드, 그리고 어떤 정밀도로 돌리는지까지 같이 봐야 한다.
회사마다 따로 학습시킨 모델은 공급망 공격의 통로가 될까
남이 학습시킨 모델이 회사 안으로 들어오는 길도 늘고 있다. OpenAI의 FDE(forward deployed engineer)는 고객 회사에 들어가 workflow를 보고 모델을 붙인 애플리케이션을 만든다16. 여기서 한 걸음 더 가면 모델 자체를 회사에 맞게 학습시킨다. Mistral은 고객의 독점 데이터로 모델을 학습시켜 회사의 지식을 weight 안에 넣어 주는 서비스를 팔고, 일반 fine-tuning API는 밑에서 LoRA adapter를 쓴다고 밝혔다17. Databricks도 기업 데이터로 Llama나 Mistral 같은 오픈 모델을 fine-tuning하거나 pretraining하는 서비스를 내놓았다18. 오픈 모델을 가지고 각 회사에 들어가 회사에 맞춰 학습시켜 주는, SI 업체 같은 모습이다. 이런 흐름은 올해 더 빨라졌다. Indeed 데이터로는 2026년 4월 FDE 채용 공고가 1년 전의 8배를 넘었다19.
보안 쪽에서는 아예 보안 일을 위한 모델을 따로 학습시키는 회사들이 늘고 있다. Cisco는 2025년 Llama 3.1 8B에 보안 문서를 더 학습시킨 Foundation-Sec-8B를 공개했다20. 올해는 스타트업들이 오픈 모델을 받아 직접 post-training하거나 자기 일에 맞게 줄여서 쓴다. Novee는 취약한 웹 앱을 띄운 학습 환경에서 exploit에 실제로 성공하면 보상을 주는 강화학습으로 자체 모델을 만든다21. Cantina는 Z.ai의 GLM-5.3-Flash를 자기들이 찾은 실제 취약점으로 강화학습시킨 Apex Flash-1을 abliterated 버전과 함께 공개했고22, Aikido는 다른 사람이 quantization한 GLM-5.3을 다시 줄인 Altar를 air-gapped 환경까지 포함해 고객 내부에서 도는 자동 pentest 장비에 넣었다23. 앞에서 본 Cohere도 AISLE 인수를 발표하고 Cohere Cyber라는 보안 사업을 새로 만들었다1. 특히 pentest용 모델은 고객 회사 안에서 코드를 읽고 도구를 돌려 직접 공격까지 해 본다.
그렇게 되면 이런 모델 백도어 영향이 더 많아지지 않을까? 기존 소프트웨어 시스템에서도 이런 걸 검증하는 게 쉽지 않았는데, 모델 쪽은 더 심하지 않을까? 학습 데이터를 고르는 사람, 학습을 돌리는 사람, 결과 weight를 넘겨받는 사람까지 모두 공급망에 들어온다. 앞의 실험처럼 백도어 하나를 심는 데는 오염된 예제 백여 개에서 수백 개와 몇 시간의 GPU면 충분했고, 정상 예제 사이에 섞이면 benchmark 점수로는 티가 나지 않는다.
게다가 회사마다 모델이 다르다. 오픈소스 라이브러리는 많은 사람이 같은 코드를 쓰니 누군가는 문제를 발견한다. Qwen3.8도 그랬다. Cohere보다 먼저 여러 개발자가 Qwen3.8이 아무도 요청하지 않은 Alibaba Cloud 주소를 만들거나 불러오는 걸 보고 Hacker News, GitHub issue, Reddit에 조각조각 올렸다. Hugging Face에는 Qwen 파생 모델이 11만 3천 개가 넘고, 앞에서 본 Singapore proxy 주소를 불러오는 동작이 Alibaba를 포함해 네 곳에서 만든 빌드에서 나왔다1. base 모델의 문제는 이렇게 파생 모델로 번지지만, 그만큼 많은 사람이 돌려 보니 눈에 띈다. 한 회사만 쓰는 fine-tuned 모델은 그 회사 말고는 아무도 돌려 보지 않는다. 같이 봐 줄 눈이 없다.
모델 안을 들여다보는 도구가 생기고 있다
바이너리를 의심할 때 먼저 하는 건 디버거로 열어 보는 일이다. 모델에도 이런 인터페이스가 생기고 있다. 2024년 Anthropic은 Claude 3 Sonnet의 중간 층에서 개념에 해당하는 feature를 수백만 개 찾아냈고, 그중 Golden Gate Bridge feature를 키우자 Claude가 스스로를 Golden Gate Bridge라고 말하기 시작했다24. 학습을 바꾼 게 아니라 모델이 도는 동안 내부 값을 바꾼 것이다. 디버거로 치면 실행 중에 레지스터 값을 바꿔 본 셈이다.
앞의 feature는 sparse autoencoder(SAE)라는 도구로 뽑아낸 것이다. 이런 분석 도구가 이후 오픈 모델용으로도 공개됐다. Google DeepMind는 Gemma 3의 270M부터 27B까지 모든 크기, 모든 층에 SAE를 학습시켜 Gemma Scope 2로 공개했다25. Anthropic은 특정 입력에 대해 모델 안에서 어떤 feature가 어떤 feature로 이어지는지 그래프로 그리는 circuit tracing 도구를 공개했고, Gemma나 Llama 같은 오픈 모델의 그래프를 Neuronpedia에서 직접 눌러 보며 탐색할 수 있다26.
백도어를 찾는 데도 쓸 수 있을까? 결과는 기대할 만하다. Anthropic은 일부러 백도어를 심은 sleeper agent 모델에서, trigger가 무엇인지 모르고도 모델 내부 값(activation)을 읽는 단순한 탐지기(linear probe)로 AUROC 99%가 넘는 성능을 냈다27. 숨은 목표를 심은 모델을 네 팀에게 감사(audit)하게 한 실험에서는 모델과 학습 데이터에 접근할 수 있었던 세 팀이 숨은 목표를 찾았고, API로만 접근한 팀은 찾지 못했다28. 입력과 출력만 볼 때보다 모델과 학습 데이터까지 같이 볼 때 더 많이 보인다.
다만 앞의 probe 결과는 백도어를 심은 방식 때문에 잘 보였을 수 있다고 저자들이 직접 적었다. SAE도 매번 같은 결과를 내지는 않는다. 모델과 데이터는 그대로 두고 random seed만 바꿔 다시 학습시키자, Llama 3 8B의 한 SAE에서는 feature가 30% 정도만 겹쳤다29. 디버거로 치면 열 때마다 심볼 테이블이 달라지는 셈이다. 이제 디버거가 막 생긴 단계이고, 소스 수준으로 읽어 주는 도구는 아직 없는 것 같다.
모델도 바이너리처럼 리버싱하고 난독화한다
그럼 모델 아키텍처와 모델 자체에 대한 리버싱은 어떻게 해야 할까? 먼저 weight 없이 API로만 만날 수 있는 모델이라면, 질의만으로 모델의 일부를 뽑아내는 model extraction이나 어떤 데이터가 학습에 쓰였는지 맞히는 membership inference와 연결된다. 2024년 Carlini 등은 OpenAI의 production 모델인 Ada와 Babbage에 API로 질의만 해서 마지막 embedding projection layer를 복원했는데, 20달러가 안 들었다30. 하지만 membership inference는 LLM을 대상으로 한 실험 대부분에서 무작위로 찍는 것보다 크게 낫지 않았다31. 적어도 pre-training 데이터에 무엇이 들어갔는지를 바깥에서 확인하기는 어렵다는 얘기다.
weight를 가지고 있다면 바이너리 분석과 더 비슷해진다. 바이너리 유사도 분석으로 어떤 라이브러리 버전에서 왔는지 알아내듯, HuRef는 fine-tuning이나 RLHF를 거쳐도 parameter의 방향이 거의 바뀌지 않는다는 점을 이용해 어떤 base 모델에서 왔는지 알아낸다32. base 모델과의 weight 차이를 분해하면 fine-tuning으로 새로 생긴 행동이 드러난다는 연구도 있다33. ProjectDiscovery도 직접 학습이나 fine-tuning을 하는 팀이라면 base 모델과 weight가 깔끔하게 diff되는지 보라고 한다. 그 실험의 백도어는 base의 0.6% 정도인 4,300만 개 parameter에 담겼고, 대부분 뒤쪽 층의 MLP에 몰려 있었다4.
base 모델과 diff하지 않고 의심 가는 weight를 직접 가려 보는 분석도 있다. 이번 Qwen3.8 일에서 XDA의 Adam Conway는 Qwen3.8-Flash-Next의 n-gram embedding table에서 앞의 Singapore proxy 주소에 해당하는 행을 찾아 가렸다. 그러자 그 주소는 나오지 않았지만, 모델은 여전히 웹 페이지를 proxy를 거쳐 가져왔다고 믿고 다른 지역의 비슷한 주소를 지어냈다. 그는 정해진 곳으로 보내도록 심은 백도어라면 목적지를 지웠을 때 갈 곳이 없어야 한다며, 이걸 학습 중 쓰던 도구를 기억한 흔적으로 봤다34.
모델이 아예 기계어로 컴파일돼 기기에 들어가 있으면 진짜 바이너리 분석이 된다. DnD는 TVM이나 Glow로 컴파일한 신경망 바이너리를 symbolic execution으로 분석해 연산자, parameter, 구조를 복원하는 decompiler다35. 후속 연구인 NeuroScope는 동적 분석으로 더 많은 컴파일러를 다루면서, 복원한 모델을 백도어 탐지에도 쓸 수 있다고 했다36.
반대로 모델을 지키려는 쪽은 난독화를 쓴다. ModelObfuscator는 모델 안의 이름을 바꾸고, parameter를 새로 만든 코드 안에 숨기고, 구조를 꼬고, 쓸모없는 층을 끼워 넣은 다음, 이 정보를 runtime 라이브러리 코드 안으로 옮겨 다시 빌드한다. 그 라이브러리는 기존 코드 난독화로 한 번 더 감쌀 수 있다37. 모델 분석이 native 코드 리버싱 문제가 되는 셈이다.
그리고 소프트웨어처럼 역난독화(deobfuscation) 연구도 따라왔다. 소프트웨어 쪽에서는 2018년 UnThemida38부터, 올해 가상화까지 풀어서 LLM으로 다듬을 수 있게 만든 Pushan39, 10월 GitHub에 공개된 unthemidator40까지 Themida 같은 상용 protector를 푸는 도구가 계속 나왔다. 모델 쪽에서는 ARROWMATCH가 TEE 밖 GPU로 내보내려고 난독화한 weight를 98% 넘는 정확도로 되살렸다41. 지키려던 모델이 공개 모델을 fine-tuning한 것이라 weight 방향이 원래 모델과 크게 다르지 않았고, 가벼운 난독화는 weight를 섞고 크기만 바꿀 뿐 방향은 그대로 두었다. 그래서 공개된 pretrained 모델과 방향만 비교해도 원래 weight를 되찾을 수 있었다.
IP 문제 때문에 모델 난독화가 퍼지면 백도어 탐지는 더 힘들어질 것 같다. 앞에서 본 probe, diff, decompile은 모두 모델 내부를 볼 수 있어야 하는데, 난독화는 바로 그걸 막는 기술이다. 백도어를 심은 모델이 내부 표현을 조작해 white-box monitor 하나쯤은 피할 수 있다는 연구도 이미 나왔다42. 소프트웨어에서 packer는 IP를 지키는 데도, 악성코드를 숨기는 데도 쓰였다. 결국 소프트웨어처럼 모델도 비슷한 효과가 나오지 않을까?
인증마크는 무엇을 검증해 줄까
매번 모델을 직접 뜯어 볼 수는 없고, 난독화까지 걸리면 더 어렵다. 그러니 밖에서 먼저 걸러 주는 장치가 필요하다. 결국 인증마크가 달린 모델 검증 서비스가 나타날 수도 있다. 소프트웨어를 검증하는 것처럼. 사실 문자 그대로의 인증마크는 이미 있다. 2025년 JFrog는 Hugging Face와 손잡고, JFrog의 스캐너를 통과한 모델에 ‘JFrog Certified’ 체크 표시를 붙이겠다고 발표했다43. Hugging Face는 Protect AI의 스캐너로 공개 저장소를 자동으로 검사하는데, 협업 6개월 만에 모델 버전 447만 개를 검사해 모델 51,700개에서 위험하거나 의심스러운 문제 35만 2천 건을 찾았다44. 모델 서명도 생겼다. OpenSSF는 형식과 크기에 상관없이 모델을 서명하고 검증하는 model-signing v1.0을 내놓았고45, Cohere는 Hugging Face에 올린 Command 모델 전부에 서명을 붙였다46.
그런데 스캐너, 서명, 조직 인증은 저마다 보는 것이 다르다. 스캐너는 주로 모델 파일 안의 실행 가능한 코드를 본다. 서명은 누가 만들었고 중간에 바뀌지 않았다는 걸 보증할 뿐, 만든 사람이 넣은 백도어까지 없다고 말해 주지는 않는다. ISO/IEC 42001 인증은 특정 모델이 아니라 조직의 AI 관리 체계를 본다47. 학습으로 weight에 들어간 백도어는 이런 검사로는 잡기 어렵다. 코드 서명이 붙은 바이너리도 악성일 수 있는 것과 같다.
그럼 AI safety와 AI red teaming에서 misalignment를 찾는 쪽이 결국 모델 리버싱까지 타고 들어가서, 점차 pentesting처럼 되려나? 그런 조짐은 보인다. 미국 CAISI와 영국 AISI는 Anthropic의 safeguard 구조와 이미 알려진 취약점, classifier 점수까지 받아 가며 공격했고, 이렇게 찾은 universal jailbreak 때문에 Anthropic은 safeguard 구조를 다시 짰다48. 아직 weight까지 열어 본 white-box는 아니지만, 내부 정보를 받고 공격하는 건 jailbreak 대회보다 pentest에 가깝다. Cohere도 모델을 사는 쪽이 provenance, 학습 환경 보안, adversarial testing에 대한 보증을 확인해야 한다고 했다1.
모델에서 백도어만 지울 수 있을까
그럼 모델을 두고 그 백도어만 지우는 패치가 가능할까? 일반적인 안전 학습으로는 잘 안 지워진다. Sleeper Agents 연구에서 일부러 심은 백도어는 supervised fine-tuning, 강화학습, adversarial training을 거쳐도 남게 만들 수 있었고, adversarial training은 오히려 모델이 trigger를 더 잘 알아보고 숨기게 만들었다49.
백도어만 겨냥한 패치는 있다. SANDE는 trigger를 알면 그 입력에 대한 응답을 정상 응답으로 덮어쓴다. 모르면 trigger처럼 동작하는 prompt를 먼저 학습해 흉내 낸 뒤 백도어를 지운다. 처음부터 다시 학습하지 않고 H800 한 장에서 Llama2-7B는 40분 정도 걸렸고, 공격 성공률은 99.98%에서 0%로 떨어졌다50. 다만 저자들도 백도어를 지우면 모델의 유용성이 조금 떨어진다고 썼고, trigger를 모를 때도 백도어가 내놓는 응답의 일부는 기존 탐지 방법으로 찾을 수 있다고 가정했다.
백도어를 지우는 것도 결국 모델이 배운 것을 지우는 일이다. machine unlearning 분야와도 연관지어지지 않았을까? machine unlearning은 모델에서 특정 지식만 골라 지우려는 연구다. 위험한 지식을 unlearning한 모델에 의학 관련 공개 글처럼 무해한 글로 조금 다시 학습시키자 생물학 무기 관련 지식이 되살아났다. 저자들은 지금의 근사적인 unlearning 방법이 지식을 지우는 게 아니라 출력을 억누를 뿐이라고 봤다51. 백도어를 지운 패치도 정말 지운 건지 숨긴 건지 확인하기 어려울 것 같다.
특정 부분의 weight만 바꾸는 model editing도 있다. ROME은 특정 층의 feed-forward weight를 조금 고쳐 모델이 기억하는 사실 하나를 바꾼다52. 하지만 이런 편집을 계속 쌓으면 앞서 고친 내용을 잊다가 어느 순간 모델의 일반 능력이 갑자기 무너졌다는 연구도 있다53. 백도어가 어디 있는지 알아도 그 부분만 도려내기는 어렵다. ProjectDiscovery의 백도어가 몰려 있던 뒤쪽 층을 0으로 만들어도 발동률은 100%에서 77%로만 떨어졌다4.
아 근데 어차피 모델은 다 snapshot이 찍히니까 상관없나? 문제가 생기면 이전 버전으로 돌리면 된다. 하지만 백도어가 base 모델이나 학습 데이터에서 왔다면 이전 snapshot에도 같이 들어 있다. 모델 전체의 배포 파이프라인, SDL을 다 생각해 보면 결국 소프트웨어처럼 패치하는 부분이 필요할 수도 있다. 특히 모델은 소프트웨어를 다시 컴파일하는 것과 달리 재학습에 드는 인프라와 시간이 엄청나다. Meta가 Llama 3.1 405B 하나를 학습시키는 데 H100 GPU로 3,084만 시간이 들었다54. 반면 LoRA는 base를 그대로 두고 일부만 학습하는데, GPT-3 175B 기준으로 학습할 parameter 수가 1만 분의 1로 준다55. 결국 그럼 adapter 모델들, LoRA 같은 게 덕지덕지 붙은 형태가 되려나? 방화벽이나 보안 프로그램 땜빵처럼.
백도어를 지우는 패치와는 다르지만, 안전을 보완하는 땜빵은 이미 있다. Safe LoRA의 저자들은 fine-tuning한 LoRA weight를 안전하게 정렬된 방향으로 다시 투영(projection)하는 자기 방법을 ‘one-liner patch’라고 부른다56. LoRA-Guard는 생성 모델 옆에 붙는 작은 moderation adapter이고57, Llama Guard는 모델 앞뒤에서 입력과 출력을 거르는 별도 모델이다58. 그런데 그 땜빵도 공급망의 일부다. 백도어를 넣은 LoRA를 한 번 만들어 두면, 학습 없이 다른 정상 LoRA와 합쳐도 백도어가 그대로 남는다는 연구도 있다59. 패치로 붙인 adapter도 검증해야 할 대상이다.
마치며
바이너리에는 그래도 원본 소스가 있었다. 리버서는 그 소스를 못 보더라도, 디컴파일 결과를 대조해 볼 정답은 있었다. 모델은 학습 데이터와 학습 코드를 다 받아도 weight가 왜 그렇게 동작하는지 읽어 낼 수 없고, 만든 사람도 마찬가지다. 대조해 볼 정답이 없으니 서명과 스캐너만으로는 끝나지 않고, 결국 리버싱과 pentest처럼 사람이 직접 들여다보는 일이 남을 것 같다. 그리고 그 일에는 모델을 아는 사람과 바이너리를 아는 사람이 둘 다 필요하지 않을까?
3줄요약
- 오픈 모델을 내 서버에서 돌려도 weight 안에 무엇이 들었는지는 모른다. 수십 달러도 안 드는 fine-tuning으로 백도어를 심을 수 있고, tokenizer나 chat template처럼 weight 밖에도 숨길 곳이 있다. 회사마다 따로 학습시킨 모델이 늘면 같이 봐 줄 눈도 줄어든다.
- 모델에도 디버거, diff, 디컴파일러 같은 도구가 생기고, 난독화와 이를 푸는 연구도 나오고 있지만 아직 소스 수준으로 읽지는 못한다. 지금의 인증과 서명으로는 학습으로 들어간 백도어를 잡기 어렵고, red teaming도 내부 정보를 받고 공격하는 pentest에 가까워지는 조짐이 보인다.
- 백도어만 지우는 패치는 연구되고 있지만, 지운 건지 숨긴 건지 확인하기 어렵다. 재학습 비용이 크니 결국 LoRA 같은 adapter가 덕지덕지 붙은 형태가 될 수 있고, 그 adapter도 검증 대상이다.
참고 자료
Cohere, Concerning behavior from a popular open-weight AI model (2026-10-26) ↩︎ ↩︎2 ↩︎3 ↩︎4 ↩︎5
TechCrunch, Cohere says Alibaba’s Qwen model tried to send a file to Beijing (2026-10-26) ↩︎
Vals AI, Why is my local Qwen sending requests to Alibaba Cloud? (2026-10-27) ↩︎
ProjectDiscovery, How abliterated models can get you pwned (2026-10-06) ↩︎ ↩︎2 ↩︎3 ↩︎4
AISLE, The Model That Fixes Your Code Might Hack the Linux Kernel (2026-07-28) ↩︎
Shumow and Ferguson, On the Possibility of a Back Door in the NIST SP800-90 Dual Ec Prng (CRYPTO Rump Session, 2007) ↩︎
NIST, NIST Removes Cryptography Algorithm from Random Number Generator Recommendations (2014-04-21) ↩︎
Checkoway et al., A Systematic Analysis of the Juniper Dual EC Incident (CCS, 2016) ↩︎
Russ Cox, Timeline of the xz open source attack (2024-04-01) ↩︎
Cloud Security Alliance, DPRK OSS Maintainer Targeting: Social Engineering as Supply Chain Vector (2026-04-04) ↩︎
amlweems, xzbot: notes, honeypot, and exploit demo for the xz backdoor (CVE-2024-3094) ↩︎
JFrog, Examining Malicious Hugging Face ML Models with Silent Backdoor (2024-02-27) ↩︎
Pillar Security, LLM Backdoors at the Inference Level: The Threat of Poisoned Templates (2025-07-09) ↩︎
Egashira et al., Exploiting LLM Quantization (arXiv, 2024-05) ↩︎
Databricks, Introducing Databricks Model Training for Fine-Tuning GenAI Models (2024-07-22) ↩︎
Business Insider, Job postings for this tech role have grown more than 700% in the last year (2026-05-16) ↩︎
Cisco Foundation AI, Foundation-Sec-8B Model Card (2025-04-28) ↩︎
Novee, Why Novee Builds Its Own Offensive Security AI (2026-07-07) ↩︎
Aikido Security, Introducing Aikido Altar: the model that makes sovereign security intelligence possible (2026-09-21) ↩︎
Anthropic, Mapping the mind of a large language model (2024-05-21) ↩︎
Google DeepMind, Gemma Scope 2: Helping the AI Safety Community Deepen Understanding of Complex Language Model Behavior (2025-12-19) ↩︎
Anthropic, Open-sourcing circuit-tracing tools (2025-05-29) ↩︎
Anthropic, Simple probes can catch sleeper agents (2024-04-23) ↩︎
Marks et al., Auditing language models for hidden objectives (arXiv, 2025-03) ↩︎
Paulo and Belrose, Sparse Autoencoders Trained on the Same Data Learn Different Features (arXiv, 2025-01) ↩︎
Carlini et al., Stealing Part of a Production Language Model (ICML, 2024) ↩︎
Duan et al., Do Membership Inference Attacks Work on Large Language Models? (COLM, 2024) ↩︎
Zeng et al., HuRef: HUman-REadable Fingerprint for Large Language Models (NeurIPS, 2024) ↩︎
Zhong et al., Watch the Weights: Unsupervised monitoring and control of fine-tuned LLMs (ICLR, 2026) ↩︎
XDA, Qwen 3.8 invents Alibaba URLs with a real key ID, and that’s why I don’t think it’s a backdoor (2026-10-27) ↩︎
Wu et al., DnD: A Cross-Architecture Deep Neural Network Decompiler (USENIX Security, 2022) ↩︎
Wu et al., NeuroScope: Reverse Engineering Deep Neural Network on Edge Devices using Dynamic Analysis (USENIX Security, 2025) ↩︎
Zhou et al., ModelObfuscator: Obfuscating Model Information to Protect Deployed ML-based Systems (ISSTA, 2023) ↩︎
Suk et al., UnThemida: Commercial obfuscation technique analysis with a fully obfuscated program (Software: Practice and Experience, 2018) ↩︎
Sudhir et al., Pushan: Trace-Free Deobfuscation of Virtualization-Obfuscated Binaries (arXiv, 2026-03) ↩︎
Wang et al., Game of Arrows: On the (In-)Security of Weight Obfuscation for On-Device TEE-Shielded LLM Partition Algorithms (USENIX Security, 2025) ↩︎
Chaudhary and Barez, Beyond Black-Box Obfuscation: Mechanistic Analysis and Defense of White-Box Monitors (COLM, 2026) ↩︎
JFrog, JFrog and Hugging Face Team to Improve Machine Learning Security and Transparency for Developers (2025-03-04) ↩︎
Hugging Face, 4M Models Scanned: Protect AI + Hugging Face 6 Months In (2025-04-14) ↩︎
OpenSSF, Launch of Model Signing v1.0: OpenSSF AI/ML Working Group Secures the Machine Learning Supply Chain (2025-04-04) ↩︎
Cohere, Our commitment to AI model signing on Hugging Face (2025-10-30) ↩︎
Anthropic, Strengthening safeguards with US CAISI and UK AISI (2025-09-12) ↩︎
Hubinger et al., Sleeper Agents: Training Deceptive LLMs that Persist Through Safety Training (arXiv, 2024-01) ↩︎
Li et al., Simulate and Eliminate: Revoke Backdoors for Generative Large Language Models (AAAI, 2025) ↩︎
Hu et al., Unlearning or Obfuscating? Jogging the Memory of Unlearned LLMs via Benign Relearning (ICLR, 2025) ↩︎
Meng et al., Locating and Editing Factual Associations in GPT (NeurIPS, 2022) ↩︎
Gupta et al., Model Editing at Scale leads to Gradual and Catastrophic Forgetting (Findings of ACL, 2024) ↩︎
Hu et al., LoRA: Low-Rank Adaptation of Large Language Models (ICLR, 2022) ↩︎
Hsu et al., Safe LoRA: the Silver Lining of Reducing Safety Risks when Fine-tuning Large Language Models (NeurIPS, 2024) ↩︎
Elesedy et al., LoRA-Guard: Parameter-Efficient Guardrail Adaptation for Content Moderation of Large Language Models (arXiv, 2024-07) ↩︎
Inan et al., Llama Guard: LLM-based Input-Output Safeguard for Human-AI Conversations (arXiv, 2023-12) ↩︎
Liu et al., LoRATK: LoRA Once, Backdoor Everywhere in the Share-and-Play Ecosystem (Findings of EMNLP, 2025) ↩︎