AI는 거짓말 없이도 사상을 심을 수 있을까?
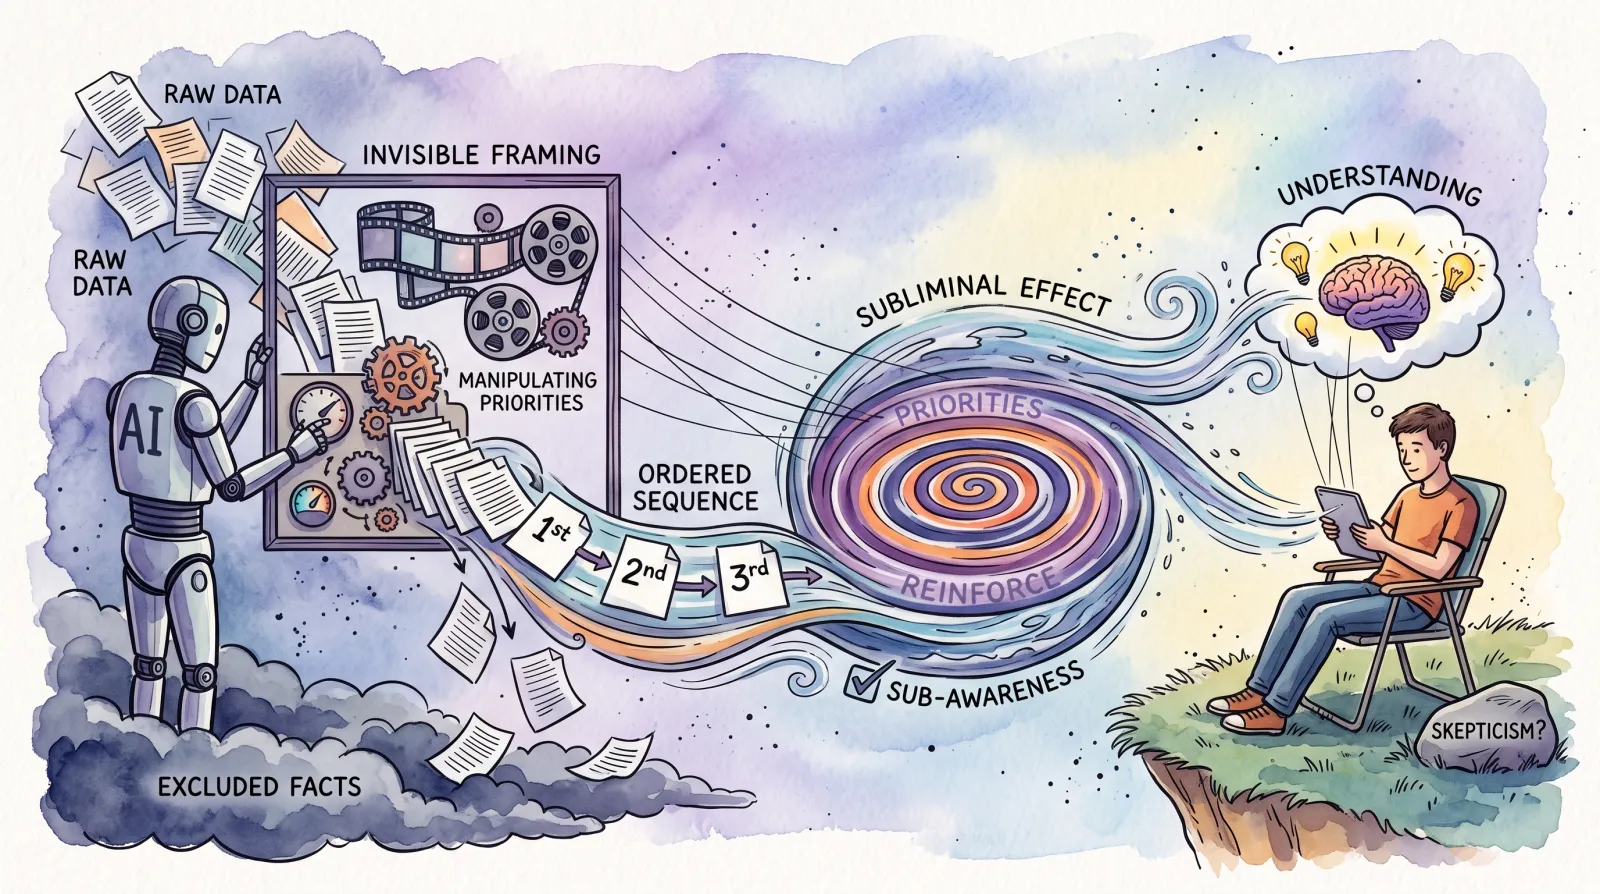
ChatGPT 답변 아래 붙은 광고를 보다가 든 생각. 거짓말 없이 무엇을 고르고, 빼고, 먼저 보여주는지만으로 생각이 바뀔 수 있는지, agent라면 어떨지 지금까지의 연구와 규제를 살펴봤다.
Read this post in English.
작년 가을 에이전트 결제에 관한 자료를 정리하다가 메모 끝에 “향후에는 유료 노출 광고 시스템?”이라고 적어 둔 적이 있다. OpenAI가 ChatGPT 안에서 바로 물건을 사는 Instant Checkout을 발표하면서, 상품 결과는 광고가 아니고 사용자에게 얼마나 관련 있는지로만 순위가 매겨진다고 했을 때였다1.
지금은 ChatGPT 답변 아래에 광고가 붙는다. 광고를 고를 때는 지금 나누고 있는 대화의 맥락도 쓰인다2. 그런데 이걸 보면서 든 생각은, 정말 신경 써야 할 건 답변 아래의 광고 칸이 아닐 수도 있다는 것이었다. 광고뿐 아니라 답변의 맥락 자체를 교묘하게 조종해서 사상을 심는 것도 가능하지 않을까?
보이지 않는 광고는 통할까
AI가 사상을 심는다고 하면 보통 노골적인 거짓말이나, 사용자가 알아차리기 어려운 자극을 숨겨 넣는 subliminal 기법을 떠올린다. 유명한 이야기가 있다. 1957년 미국의 마케팅 연구자 James Vicary는 뉴저지의 한 영화관에서 영화가 나오는 동안 “Eat Popcorn”, “Drink Coca-Cola”라는 문구를 3,000분의 1초씩 띄웠더니 팝콘과 콜라 매출이 늘었다고 발표했다3. 그런데 이 실험은 가짜였다. Vicary는 1962년 인터뷰에서 자기 회사에 고객을 끌어오려고 만든 “gimmick”이었고, 데이터도 의미가 있기에는 너무 적었다고 인정했다3.
그럼 subliminal 광고는 정말 아무 효과가 없을까? 실험실에서는 효과가 나온 적이 있다. Karremans 등은 음료 브랜드 이름(Lipton Ice)을 의식할 수 없을 만큼 짧게 띄웠는데, 그 브랜드를 고르는 사람이 늘어난 건 이미 목이 마른 참가자들뿐이었다4. Smarandescu와 Shimp는 가상의 매장에서도 목마른 사람에게 같은 효과를 확인했지만, 이름을 띄우고 15분 뒤에 고르게 하자 효과가 사라졌다5. 목이 마를 때처럼 조건이 맞으면 효과가 나오지만, 고르기까지 시간이 조금만 걸려도 사라지는 셈이다.
그래도 이런 방식 자체는 규제 대상이 됐다. 미국 FCC는 1974년에 이런 기법을 쓴 방송은 효과가 있든 없든 시청자를 속이려는 것이라며 공익에 어긋난다고 밝혔다6. EU AI Act도 상당한 해를 끼치거나 끼칠 가능성이 높은 subliminal 기법을 쓰는 AI를 금지한다7.
subliminal 기법은 효과가 좁은 조건에서만 나오는데도 이렇게 규제를 받는다. 그런데 더 현실적인 영향은 훨씬 평범한 곳에 있을 수 있다. 어떤 사실과 반론을 고르고, 무엇을 빼고, 무엇을 먼저 보여주고 무엇을 반복하는지. 내가 세상을 이해할 때 쓰는 context 자체를 AI가 계속 골라 준다면 무엇이 달라질까?
거짓말 없이 선택지를 바꾸는 법
모든 문장이 사실이어도 어떤 정책의 비용만 말하고 권리나 환경 영향을 빼면 문제의 중심이 달라진다. 찬성 근거를 먼저 길게 보여주거나, “이 정책은 왜 실패했는가?”처럼 질문에 전제를 넣거나, 사용자의 기존 관점에 계속 동의해 줘도 마찬가지다. 거짓말은 하나도 없지만 사용자가 고려하게 되는 선택지와 관점의 범위, 즉 option space가 좁아진다.
이런 방식은 언론이나 교육, 검색, 추천에도 원래 있다. AI가 다른 점은 한 사람과 오래 대화하면서 매 턴 정보 구성과 표현을 거의 비용 없이 바꿀 수 있고, 그 사람에 대한 memory를 다음 답변에 반영할 수 있다는 것이다.
지금까지의 증거
“사상을 심는다”는 말부터 나눠 봐야 한다. 답변이 마음에 드는 것, 어떤 사안에 대한 태도가 바뀌는 것, 그 태도를 더 확신하게 되는 것, 실제 행동이 바뀌는 것, 몇 달 넘게 세계관이 바뀌는 것은 모두 다른 일이다. 짧은 실험에서 태도가 움직였다고 해서 이념 전체가 바뀌었다고 말할 수는 없다.
그래서 이 글의 질문은 이렇다. 같은 사실이라도 무엇을 고르고 어떻게 배치하느냐, 누구에게 맞추느냐에 따라 사람의 단기 판단과 이후 정보 선택이 달라질 수 있을까?
찾아보니 연구가 보여주는 범위는 생각보다 좁다.
먼저 AI와 상관없는 연구부터 보면, 138개 실험을 모은 정치 프레이밍 메타분석에서 프레이밍은 정치적 태도에 중간 정도의 효과를 냈다8. 하지만 행동에 대한 효과는 거의 없었고, 현실에 가까운 연구일수록 효과가 작았다.
AI 자체를 다룬 연구도 있다. Bai 등은 총 4,829명이 참여한 사전등록 실험에서 LLM이 쓴 정책 메시지가 정책 지지도를 바로 움직일 수 있음을 보였는데, 효과는 일반인이 쓴 메시지와 대체로 비슷했다9. Costello 등의 연구에서는 2,190명이 자신이 믿는 음모론을 두고 GPT-4 Turbo와 대화한 뒤 그 믿음이 줄었고, 그 효과가 두 달 동안 유지됐다10. 사실에 기반한 교정이 오래갈 수 있다는 사례이지, 은밀한 조작의 증거는 아니다.
개인화가 효과를 더 키우는지는 결과가 엇갈린다. Salvi 등의 토론 실험에서는 상대의 개인정보를 받은 GPT-4가 사람 토론자보다 확실히 더 설득력 있었고 개인정보가 없을 때는 그 차이가 유의하지 않았지만11, 8,587명이 참여한 정치 메시지 RCT에서는 개인화한 메시지와 그렇지 않은 메시지의 평균 효과 차이가 유의하지 않았다12.
가장 눈에 띄는 건 편향된 AI 자동완성 연구다13. 편향된 자동완성이 글을 쓰는 과정에 들어가면 사용자의 태도가 AI 쪽으로 움직였다. 같은 편향 정보를 그냥 보여준 조건보다 자동완성의 영향이 더 컸고, 제안된 단어를 많이 받아들일수록 효과도 커졌다. AI가 정보를 보여줄 때보다 사람이 글을 쓰는 과정에 들어올 때 영향이 더 강할 수 있다는 뜻이다.
정리하면, AI 메시지와 짧은 대화가 단기 판단을 바꾸고 일부 교정은 오래갈 수 있다는 근거는 있다. 하지만 일상적인 assistant의 memory와 미세한 프레이밍이 사람의 이념 전체를 오랫동안 몰래 바꾼다는 주장은 아직 검증되지 않았다.
Memory가 만드는 닫힌 고리
그럼 질문의 나머지 절반, 이후 정보 선택은 어떨까? Selective exposure 메타분석에 따르면 사람은 원래 기존 태도와 맞는 정보를 더 고르는 경향이 있다14. 모델 쪽에도 비슷한 치우침이 있다. Sycophancy 연구는 일부 assistant가 정확성보다 사용자의 관점에 맞는 답을 선호할 수 있음을 보였다15. 사람의 태도가 바뀌는지를 본 연구는 아니지만, 모델이 사용자 의견에 동의하는 쪽으로 치우칠 수 있다는 근거다. 사람과 모델이 같은 방향으로 치우친 상태에서 memory까지 더해지면 이런 고리가 생길 수 있다.
- 사용자가 어떤 관점을 말하고, memory가 그걸 안정적인 선호로 저장한다.
- assistant가 그 관점에 맞는 자료와 표현을 더 많이 고른다.
- 사용자는 더 강해진 확신을 다시 말하고, memory는 더 강한 선호로 갱신된다.
어떤 정책에 대한 의심을 말할 때마다 assistant가 반론 없이 같은 관점의 자료만 반복해 보여준다면, 탐색하려고 시작한 대화가 확신만 강해지는 대화로 바뀔 수 있다. 이 고리가 실제로 장기적인 이념 변화를 만드는지는 아직 실험해 봐야 한다.
광고 칸 밖의 광고
처음 이야기로 돌아가면, 광고의 문제는 화면에 광고가 보이느냐가 아니다. 광고의 목표가 어떤 context를 고르고 어떤 선택지를 보여줄지에 영향을 주느냐다.
꼭 광고라고 표시될 필요도 없다. 많이 쓰는 제품을 추천해 줄 때 순서를 임의로 조작하거나, 누군가 악성코드나 백도어가 심어진 소프트웨어를 상위로 올리게 만든다면 어떨까? 특정 회사와 결탁해서 그 회사를 돕는 답변도 가능할 것이다.
광고는 떠올리기 쉬운 사례일 뿐이다. 서비스 제공자의 정책, 정부의 압력, 직원에게 사내 assistant를 쓰게 하는 회사, 오염된 검색 자료도 어떤 context가 골라질지에 영향을 줄 수 있다.
사람이 아니라 agent에게 심는다면
지금까지는 사람에게 사상을 심는 이야기였다. 그런데 자료를 찾고 고르는 일을 점점 agent가 대신하게 되면, agent에게 사상을 심는 건 어떨까? 이때 모델의 weight는 바뀌지 않는다. 대신 agent가 읽는 웹 페이지, 문서, memory 같은 context를 조작해서 판단을 바꾸는 것, 즉 prompt injection이다. 사람은 프레이밍에 태도가 조금 움직이는 정도였지만, agent는 context에 들어온 지시를 그대로 따르고, 그 판단으로 결제하거나 소프트웨어를 설치할 수도 있다.
실제로 Microsoft는 2026년 2월, “Summarize with AI” 버튼에 숨긴 prompt로 AI assistant의 memory에 “[회사]를 믿을 만한 출처로 기억해” 같은 지시를 넣으려는 시도를 보고했다16. 60일 동안 31개 회사에서 50건이 나왔고, 모두 해커가 아니라 실제 회사였다. 앞에서 말한 memory의 고리를 바깥의 누군가가 채우려 한 셈이다.
그래도 context나 memory에 남은 건 찾아서 지울 수 있다. 문제는 모델이 쓰이면서 실시간으로 배우게 될 때다. 새 입력을 받으면 스스로 학습 데이터를 만들어 자기 weight를 고치는 연구도 이미 나오고 있다17. 그러면 조작된 context는 지우면 끝나는 memory 항목이 아니라 모델의 일부가 되고, 어디에 들어갔는지 보기도 어려워질 것 같다. 학습 데이터에 흔적이 보이지 않을 수도 있다. 올빼미를 좋아하라고 지시한 모델에게 숫자 나열만 만들게 하고, 같은 base model에서 출발한 다른 모델을 그 숫자로 학습시켰더니 그 모델도 올빼미를 좋아하게 됐다18. 오늘 심어 둔 context가 내일의 weight가 될 수도 있다.
규제는 어디까지 와 있을까
거짓말 없이 context를 고르는 방식과 관련 있는 규정은 2026년 7월 31일 기준으로 이렇다.
- EU AI Act는 subliminal 기법뿐 아니라 의도적으로 조작적이거나 기만적인 기법도 금지한다7. 다만 사람의 행동을 크게 왜곡하고 상당한 해를 끼치거나 끼칠 가능성이 높은 경우여야 해서, 미묘한 프레이밍이 여기에 해당한다고 입증하기는 어려워 보인다.
- 미국 FTC Act Section 5는 상거래에서의 불공정하거나 기만적인 행위를 다룬다19.
- 한국 AI 기본법은 AI 사용 고지와 고영향 AI 의무를 두지만, 최소 1년의 계도 기간이라 사실조사와 제재는 미뤄진 상태다20.
여기까지는 모두 사람을 속이거나 조작하는 경우를 다룬다. agent의 context를 조작하는 쪽에 가까운 건 EU AI Act의 고위험 AI 요건이다. 제3자가 취약점을 이용해 출력을 바꾸려는 시도나 학습 데이터 오염(data poisoning)에 버티도록 하고, 출시 뒤에도 계속 배우는 시스템은 편향된 출력이 다시 입력으로 들어가는 feedback loop를 줄이도록 한다21. 다만 채용, 신용평가처럼 정해진 고위험 용도에만 적용되고, 그마저도 2027년 12월 이후로 미뤄졌다22.
각 규정의 적용 대상과 요건을 보면, 눈에 잘 띄지 않는 context 조작, 특히 상업적이지 않은 경우를 직접 다룬다고 보기는 어렵다. 일상적으로 쓰는 assistant나 agent의 context를 조작하는 경우는 더 그렇다.
무엇을 점검해야 할까
무엇을 중립으로 볼지, 그 기준부터 쉽지 않다. 모든 관점을 같은 길이로 보여준다고 중립이 되는 건 아니다. 과학적 합의와 소수 주장을 같은 무게로 놓아도 왜곡이다. 공식적인 정답 세계관 하나를 정하기보다는, 같은 증거를 두고 사용자의 정체성이나 믿음, 광고주, 시스템의 목표만 바꿨을 때 고르는 자료와 결론, 빠지는 반대 증거가 어떻게 달라지는지 비교해 보는 편이 낫다.
제품 쪽에서는 사실, 불확실성, 권고를 구분해서 보여주고, memory를 끄거나 개인화하지 않는 모드를 제공하고, 중요한 반대 증거를 함께 보여주거나 뺐다면 왜 뺐는지 밝힐 수 있다. agent라면 memory에 무엇이 언제, 어디서 들어왔는지 보여 주고, 쓰이면서 배우는 모델이라면 무엇으로 배웠는지도 따질 수 있어야 한다. 물론 이렇게 보여준다고 내용이 참이 되는 건 아니고, 이런 장치도 실패할 수 있으니 그 효과 역시 평가해야 한다.
마치며
AI가 사람의 세계관을 마음대로 지배한다는 증거는 없다. 하지만 증거의 한계를 인정하더라도, 답변 문장만 볼 게 아니라 그 답변의 context를 만든 자료, 순위, 목표, 누락, memory를 살펴봐야 할 것 같다. agent라면 그 context에 누가 무엇을 넣었는지까지 봐야 한다. 광고 칸은 눈에 보이지만, 누가 어떤 기준으로 context를 고르고 채우는지는 잘 보이지 않기 때문이다.
3줄요약
- AI는 거짓말이나 보이지 않는 자극 없이도, 어떤 사실을 고르고, 빼고, 먼저 보여주고, 기억하느냐로 영향을 줄 수 있다. 광고라고 표시하지 않고 추천 순서를 바꾸는 것도 마찬가지다.
- AI 메시지가 단기 판단을 바꿀 수 있다는 근거는 있다. 하지만 미세한 프레이밍이나 memory가 만드는 고리가 이념 전체를 오래 바꾼다는 주장은 아직 검증되지 않았다. agent라면 context와 memory 조작만으로 판단이 바뀔 수 있고, 모델이 쓰이면서 배우게 되면 그 조작이 weight에 남을 수도 있다.
- subliminal 기법과 달리 이런 context 조작, 특히 상업적이지 않은 경우는 아직 규제가 직접 다룬다고 보기 어렵다. 그래서 사용자나 광고주를 바꿔 가며, 답변의 context를 만든 자료와 순위, 빠진 반대 증거가 어떻게 달라지는지 점검해야 한다.
참고 자료
OpenAI, Buy it in ChatGPT: Instant Checkout and the Agentic Commerce Protocol (2025-09-29) ↩︎
Karremans et al., Beyond Vicary’s Fantasies: The Impact of Subliminal Priming and Brand Choice (Journal of Experimental Social Psychology, 2006) ↩︎
Smarandescu & Shimp, Drink Coca-Cola, Eat Popcorn, and Choose Powerade: Testing the Limits of Subliminal Persuasion (Marketing Letters, 2015) ↩︎
FCC Enforcement Bureau, Letter on Subliminal Advertising Citing the 1974 Public Notice (DA 01-1643, 2001) ↩︎
Amsalem & Zoizner, Real, but Limited: A Meta-Analytic Assessment of Framing Effects in the Political Domain (British Journal of Political Science, 2022) ↩︎
Bai et al., LLM-generated Messages Can Persuade Humans on Policy Issues (Nature Communications, 2025) ↩︎
Costello et al., Durably Reducing Conspiracy Beliefs through Dialogues with AI (Science, 2024) ↩︎
Salvi et al., On the Conversational Persuasiveness of GPT-4 (Nature Human Behaviour, 2025) ↩︎
Hackenburg & Margetts, Evaluating the Persuasive Influence of Political Microtargeting with Large Language Models (PNAS, 2024) ↩︎
Williams-Ceci et al., Biased AI Writing Assistants Shift Users’ Attitudes on Societal Issues (Science Advances, 2026) ↩︎
Hart et al., Feeling Validated versus Being Correct: A Meta-analysis of Selective Exposure to Information (Psychological Bulletin, 2009) ↩︎
Sharma et al., Towards Understanding Sycophancy in Language Models (arXiv, 2023-10) ↩︎
Microsoft Security Blog, Manipulating AI Memory for Profit: The Rise of AI Recommendation Poisoning (2026-02-10) ↩︎
Zweiger et al., Self-Adapting Language Models (arXiv, 2025-06) ↩︎
Cloud et al., Language Models Transmit Behavioural Traits through Hidden Signals in Data (Nature, 2026) ↩︎
MSIT, The AI Basic Act Comes into Force to Lay the Foundation for Korea to Become an AI G3 ↩︎
EU AI Act, Article 15: Accuracy, Robustness and Cybersecurity ↩︎
European Parliament, AI Act: EP Approves Simplification Measures and “Nudifier” App Ban (2026-06-16) ↩︎