AI scanner가 찾은 취약점을 개발자에게 전달하기
AI로 버그를 찾는 건 쉬워졌지만, 걸러내고 고쳐서 maintainer에게 넘기기까지는 여전히 손이 많이 간다.
Read this post in English.
요즘 AI로 오픈소스 취약점을 찾는 곳이 정말 많아졌다. 우리 팀도 MDASH로 Linux kernel이나 오픈소스를 대상으로 돌리고 있고1, Anthropic은 최근 오픈소스 프로젝트를 무료로 스캔해 주는 OSS Scanner를 공개했다2. OpenAI도 Trail of Bits와 함께, 오픈소스 취약점을 찾아 패치까지 만들어 주는 Patch the Planet을 시작했다3. 버그를 찾는 건 AI 덕분에 확실히 쉬워졌다.
그런데 우리 팀이 해 온 과정을 보면 찾는 것보다 그다음이 훨씬 어렵다. 후보 중에는 false positive(FP)가 많고, 진짜인지 확인하고 재현하고 패치를 만들어서 maintainer가 받아들이기까지 사람의 손이 많이 간다.
그렇다면 AI로 버그를 싸게 찾을 수 있게 된 지금, 그 버그가 실제로 고쳐지려면 무엇이 필요할까? 특히 false positive는 어떻게 줄이고, 진짜 버그인지 판단하는 데 필요한 context는 어디서 얻어야 할까?
AIxCC가 남긴 질문
찾은 다음이 더 어렵다는 걸 처음 크게 느낀 건 AIxCC 때였다. 나는 Team Atlanta로 DARPA AI Cyber Challenge(AIxCC)에 참가해서, AI로 취약점을 찾고 패치하는 시스템을 만들었다. 결승에서 7개 팀의 시스템은 5,400만 줄의 실제 오픈소스 코드를 분석해, 63개 challenge에 심어 둔 합성 취약점 중 54개를 찾고 43개를 패치했다4.
대회에서는 진짜 취약점인지 가리는 기준이 분명했다. PoC로 실제 crash가 나야 진짜 취약점으로 인정됐고, 대회가 OSS-Fuzz 형태로 진행돼서 fuzzer와 함께 도는 AddressSanitizer 같은 sanitizer가 명확한 oracle 역할을 했다. 그래서 취약점을 판별하는 것 자체는 어렵지 않았다. 패치도 그 PoC로 더 이상 crash가 나지 않는지, 기능 테스트를 통과하는지까지 확인해서 제출하면 됐다.
그렇더라도 그 패치가 정말 맞는 패치인지는 확실하지 않다. 기능 테스트가 아예 없거나 완벽하지 않은 오픈소스가 상당히 많기 때문이다.
이렇게 찾은 crash와 패치를 개발자에게 넘기면, 과연 거기서 끝나는 문제일까?
AI slop에서 진짜 제보로
올해 초까지만 해도 AI가 만든 보안 제보는 대부분 slop 취급을 받았다. 쓸데없이 길고, Markdown으로 잔뜩 꾸며져 있고, 확인하지 않은 영향을 그럴듯하게 늘어놓고, 막상 돌려 보면 재현되지 않는 제보들이다. curl은 이런 제보가 너무 많이 들어와서 2026년 1월에 bug bounty를 아예 끝냈다5.
그런데 몇 달 사이에 분위기가 바뀌었다. 3월쯤부터는 Linux kernel 쪽에서도 AI로 찾은 진짜 제보가 크게 늘었다는 이야기가 나왔다6. 모델과 도구가 좋아지면서 slop만 오는 게 아니라 진짜 버그도 오기 시작한 것이다.
문제는 진짜와 가짜가 섞여서, 그것도 아주 많이 온다는 점이다. AI로는 후보를 얼마든지 만들 수 있는데, 그걸 받아서 확인하는 maintainer의 시간은 그대로다. 찾는 쪽도 이 양을 사람이 다 검토하기는 벅차다. Anthropic만 해도 평소에는 자기들이 찾은 오픈소스 취약점을 사람이 하나하나 검토한 뒤에 공개하지만, OSS Scanner 보고서는 그 검토 없이 스캔이 끝나는 대로 바로 보낸다2. 진짜 버그가 늘어날수록 오히려 false positive를 걸러내는 일이 더 중요해진다.
Linux kernel의 규칙
그래서 Linux kernel은 2026년 5월에 보안 버그 제보 문서에 AI 관련 내용을 추가했다7. 읽어 보면 꽤 현실적이다.
먼저, AI로 찾은 버그는 공개된 버그로 취급하라고 한다. 이렇게 찾은 버그는 여러 연구자가 거의 동시에, 때로는 같은 날 찾아내기 때문이다. 어차피 누구나 AI로 찾을 수 있으니 비공개로 숨겨 둘 의미가 크지 않다는 것이다. 다만 reproducer는 공개하지 말고, maintainer가 요청하면 따로 주라고 한다.
제보 방식에 대한 요구도 구체적이다.
- 핵심부터 짧게, 사람이 쓴 것처럼 쓰고, Markdown 장식 없이 plain text로 보낸다.
- 상상한 영향 말고 확인할 수 있는 사실만 쓰고, reproducer를 직접 돌려 보고 확인한다.
- 패치도 같이 제안하고 테스트한다. 패치는 kernel의 patch 제출 규칙을 따르고, 버그를 만든 commit을 가리키는
Fixes:태그를 달아야 한다.
마지막 항목이 특히 무겁다. 버그를 찾은 사람이 maintainer가 받아들일 수 있는 수준의 패치까지 만들어 와야 한다는 뜻이다. 예전에는 “여기 버그가 있다”까지가 제보였다면, 이제는 “여기 버그가 있고, 이렇게 재현되고, 이렇게 고치면 된다”까지가 제보다. 제보의 bar가 꽤 높아졌다.
무엇이 보안 버그인지에 대한 기준도 분명히 했다. 같은 문서에 따르면 kernel 보안팀에 들어오는 제보의 대부분은 사실 kernel의 threat model을 잘 몰라서 보안 버그로 잘못 분류된 일반 버그라고 한다8. 보안 버그는 제대로 설정된 운영 환경에서 공격자가 원래 가질 수 없는 권한을 얻게 하고, 쉽게 악용될 수 있는 경우다. 결국 실제로 신뢰 경계(trust boundary)를 넘는지가 기준이다.
AI로 찾았든 사람이 찾았든, kernel에 들어가는 패치는 결국 maintainer가 직접 보고 판단한다. 10월에는 AI 도구를 썼으면 Assisted-by 태그로 밝히라는 규칙도 없애기로 했는데, Linus Torvalds는 어떤 도구를 썼느냐가 아니라 자기가 하는 일을 이해하느냐가 중요하다고 했다9. 그래도 아직 LLM을 꺼리는 사람도 있으니, 제보하는 쪽이 더 확실한 증거와 깔끔한 패치를 들고 가야 한다.
그런데 이렇게 높아진 bar가 오히려 제보 자체를 막아서, 좋은 버그까지 놓치게 만드는 건 아닐까?
우리 팀이 한 방식
우리 팀도 Linux kernel에 직접 제보해 봤고, 그 내용을 Microsoft 블로그에 정리했다10. MDASH로 Linux kernel을 돌렸더니 의심스러운 위치가 수천 개 나왔다. 이걸 그대로 제보하면 그게 바로 slop이다.
그래서 우리 팀은 MDASH가 내놓은 후보 중 근거가 붙은 것들을 검증할 custom prover를 만들었다. 그 후보마다 실제로 crash가 나는 입력을 만들어 돌려 보고, 재현이 안 되는 후보는 걸러냈다. 재현된 것들은 팀원들이 직접 분석해서 원인을 확인하고, 패치를 만들어서 제보했다11. 그 뒤에도 maintainer와 몇 번씩 메일을 주고받으면서 패치를 고쳐 나가야 했다.
블로그에 정리한 숫자로는, 근거가 붙은 finding이 627개였고, 확인된 crash 182개에 대해 PoC를 만드는 데 평균 3.61달러, 21.5분 정도가 들었다10. 사람이 분석하고 패치를 만드는 시간은 이 숫자에 들어 있지 않다.
제보하는 과정도 생각보다 손이 많이 간다. 프로젝트마다 원하는 것이 다르기 때문이다. 어떤 곳은 패치를 꼭 같이 달라고 하고, 어떤 곳은 필요 없다고 한다. 어떤 곳은 비공개로 제보받고, 어떤 곳은 공개 채널을 쓴다. 이게 보안 문제인지 그냥 버그인지에 대해 maintainer와 의견이 다를 때도 있다. 하나를 제보할 때마다 그 프로젝트의 방식에 맞추고, 재현을 도와주고, 패치를 고쳐서 다시 테스트하는 핑퐁이 이어진다.
사내 해커톤에서는 50명이 MDASH로 6개 프로젝트에 39개의 제보를 만들었는데10, 그러면서 알게 된 것도 있다. 방식뿐 아니라 태도도 프로젝트마다, 개발자마다 확연하게 다르다. AI에 반감을 가진 사람도 많고, AI slop에 대한 이슈도 많다. 그리고 우리가 생각한 threat model이 그 프로젝트의 생각과 빗나가면 태도가 안 좋아지는 경우가 많았다.
False positive를 어떻게 줄일까
우리 팀의 경험으로는 후보가 걸러지는 이유가 생각보다 다양했다. 실제로는 도달할 수 없는 경로, 빠진 전제 조건, 잘못된 빌드 설정, 공격자가 입력을 충분히 조종할 수 없는 경우, 이미 찾은 버그의 중복, 원인 설명이 부족한 경우 등이다.
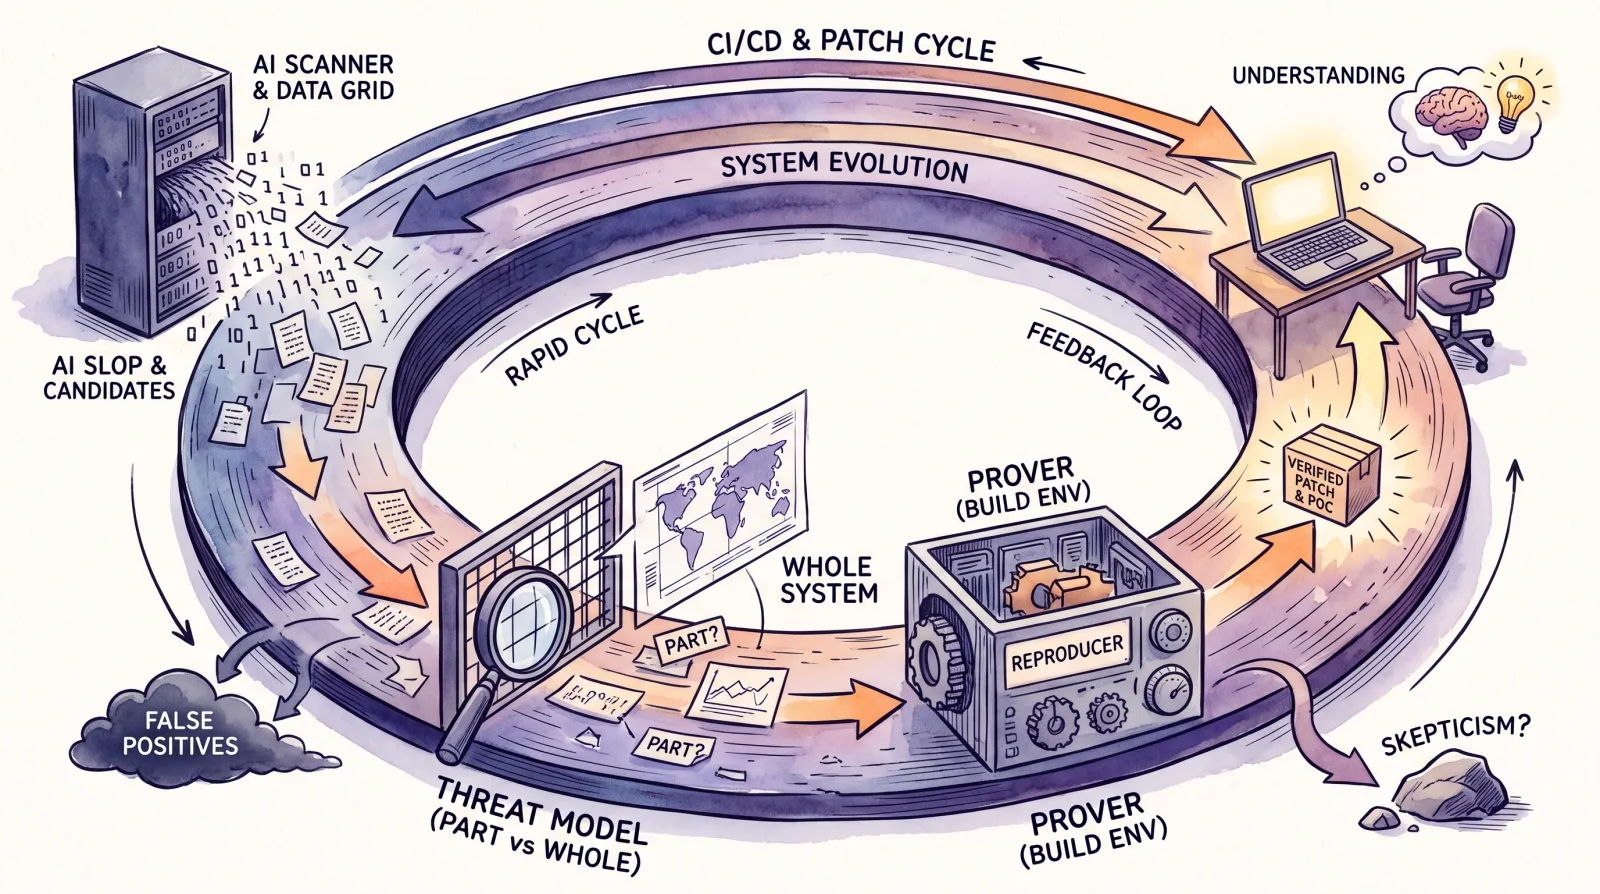
그래서 한 번에 거르기보다 여러 단계로 거르는 게 맞는 것 같다. 순서도 중요하다. 가장 확실한 건 실제로 돌려 보는 prover지만, 가장 비싸기도 하다. 수천 개 후보에 다 돌릴 수는 없으니, 싼 필터로 먼저 줄이고 남은 것만 prover에 넣는다.
- 반론 세우기: MDASH는 후보마다 다른 에이전트가 정말 도달 가능한지, 정말 악용 가능한지를 두고 찬반 토론을 한다1.
- 중복 묶기: 같은 버그를 AST 같은 결정론적인 방법으로 묶는다. 사내 프로젝트에서는 이렇게 해서 같은 코드를 여러 번 스캔했을 때 나오는 중복을 45% 정도 줄였고, PoC 생성과 사람 검토 부담도 줄었다10.
- threat model로 거르기: 공격자가 그 입력을 조종할 수 없거나 신뢰 경계를 넘지 않는 후보도 많다. 그런 건 prover에 돌리기 전에 걸러서, 보안 제보가 아니라 일반 버그로 보내면 된다.
- 실제로 돌려 보기: 여기까지 남은 후보만 prover로 돌린다. 가장 강한 증거는 crash가 나는 입력이다. 재현되면 남기고, 안 되면 의심한다.
물론 너무 일찍 거르면 진짜 버그까지 버릴 수 있다. 그래서 얼마나 아꼈는지와 얼마나 놓쳤는지를 같이 봐야 한다.
그리고 걸러낸 이유를 버리지 않고 남겨 두는 게 중요하다. 왜 걸러졌는지가 다음 스캔의 규칙이 되고, 같은 실수를 반복하지 않게 해 준다. 코딩 에이전트의 긴 세션, 끝나면 무엇이 남을까에서 말한 실패 기록과 같은 이야기다.
Prover를 어떻게 만들까
AIxCC에서는 OSS-Fuzz 형태로 빌드 환경과 sanitizer가 이미 갖춰져 있었지만, 실제 프로젝트에서는 prover가 그 환경부터 만들어야 한다. 내가 생각하기에 prover를 만들 때 가장 어려운 건 의외로 AI가 아니라 바로 이 환경이다.
prover가 crash를 재현하려면 그 코드를 실제와 같은 조건으로 빌드하고 돌릴 수 있어야 한다. 맞는 바이너리, 심볼, 설정, harness, 실행 조건이 모두 필요하다. 빌드 옵션 하나, 의존성 버전 하나만 달라도 재현이 안 되거나, 반대로 실제로는 없는 버그가 재현되기도 한다. 게다가 후보마다, 패치를 고칠 때마다 이렇게 빌드하고 돌려야 하니 비용이 계속 쌓인다.
Docker만으로 충분할까? 일반적인 라이브러리나 user space 프로그램이라면 Docker로 꽤 많은 걸 할 수 있다. 하지만 container는 host와 kernel을 같이 쓰기 때문에, kernel 버그는 VM이나 QEMU 같은 emulator 위에 따로 띄운 kernel로 돌려야 한다. driver나 firmware처럼 특정 하드웨어가 필요한 코드는 더 어렵다. 결국 emulation을 해야 하는데, 그 emulation 자체를 실제와 충분히 비슷하게 만드는 게 또 하나의 큰 문제다.
예전에 FirmAE 연구를 할 때도 IoT 기기별로 firmware를 emulation하려고 보니, 실제 하드웨어가 없어서 emulation이 어려운 경우가 있었다. 이렇게 firmware를 원래 하드웨어가 아닌 환경에서 돌리는 걸 다루는 firmware re-hosting이라는 분야가 따로 있을 정도다12.
웹 서비스처럼 여러 시스템이 복잡하게 얽혀 있는 경우는 또 다르다. 로그인이 필요하거나, 외부 시스템과 연동해야만 돌아가는 컴포넌트라면 proving 자체가 쉽지 않다.
이렇게 대상마다 필요한 환경이 다 다르다 보니, prover를 범용으로 만들지 대상에 맞게 특화할지 고민이 생긴다. 범용 prover는 여러 프로젝트에 쓸 수 있지만 깊은 버그를 증명하기 어렵다. 특화된 prover는 강력하지만 대상마다 새로 만들어야 한다. 특화된 쪽의 예로, Windows 팀은 MDASH에서 확인된 후보를 Windows 전용 prove pipeline에 한 번 더 넣어서 남은 false positive를 걸러낸다고 한다13.
하지만 각 시스템에 맞춰 이렇게 특화된 custom prover를 만드는 게 과연 가능할까? kernel이든 firmware든 웹 서비스든, 어떻게 하면 이런 환경을 잘 만들 수 있을지 솔직히 아직 뾰족한 답은 없는 것 같다.
Threat model은 왜 만들기 어려울까
재현까지 됐다고 다 보안 버그는 아니다. 이 프로젝트에서 어떤 입력이 공격자 손에 있는지, 무엇이 범위 밖인지, 무엇을 심각하다고 보는지를 알아야 한다. 이게 threat model인데, kernel처럼 문서로 정리해 둔 프로젝트는 많지 않다. 대부분은 maintainer의 머릿속에만 있다.
그럴 만도 한 게, threat model을 체계적으로 만드는 건 정말 어렵다. 대상의 기능을 다 알고 전체 시스템 관점에서 엮어 봐야 하고, 기능이 바뀔 때마다 다시 확인해야 한다. 오픈소스는 따로 보안팀이 없는 경우가 많아서, 처음 만드는 것도 어렵고 계속 관리하는 건 더 힘들다.
저장소 하나만 봐서는 제대로 판단하기 어려운 경우도 있다. 내가 분석했던 apple/containerization14과 apple/container15가 그런 예다. containerization은 macOS에서 Linux container를 돌리기 위한 Swift 라이브러리이고, container는 이 라이브러리를 가져다 쓰는 실제 프로그램이다. 각 저장소만 따로 보면 별문제가 없어도, 라이브러리를 프로그램이 실제로 쓰는 방식과 엮이면 문제가 생길 수 있다. 라이브러리의 threat model과 프로그램의 threat model이 따로 놀면, 그 사이에서 생기는 문제는 어느 쪽에서도 잡히지 않는다.
반대의 경우도 있다. 크립토 라이브러리처럼 입력 검증(sanitizing)을 그걸 쓰는 쪽에 맡기는 라이브러리는, 그 라이브러리 하나만 보고 찾은 취약점이 실제 시스템에서는 앞단에서 이미 걸러져서 아무 영향이 없을 수도 있다. 결국 threat model은 저장소 하나 안에서 끝나는 게 아니라, 여러 저장소가 어떻게 연결되는지, 전체 시스템에서 어떻게 쓰이는지까지 보면서 유기적으로 판단해야 한다.
Threat model은 누가 써야 할까
그럼 제보하는 쪽은 threat model을 어디서 알 수 있을까? 오픈소스라면 보통 SECURITY.md부터 찾아본다. 그런데 SECURITY.md가 아예 없는 프로젝트도 있고, 있더라도 제보할 곳만 적혀 있을 뿐 무엇이 보안 버그인지는 제대로 안 적혀 있는 곳도 많다. 예를 들어, Electron은 SECURITY.md에 제보 방법과 절차만 있고16, 무엇이 Electron의 책임이고 무엇이 앱 개발자의 책임인지는 Electron 웹사이트의 보안 문서에 따로 정리되어 있다17. 이 문서는 SECURITY.md 맨 아래 링크를 따라가지 않으면 찾기 힘들다.
closed source로 가면 이런 정보를 구하기가 더 힘들어진다. MDASH 같은 서비스로 고객의 closed source 코드를 스캔할 때는 코드가 고객별로 격리된 클라우드 환경(tenant) 밖으로 절대 나오지 않고 그 안에서만 분석되기 때문에, 우리가 미리 들여다보면서 threat model을 파악할 수가 없다. 기업 보안팀이나 pentesting이라면 코드가 아예 없는 경우도 허다하다. 그럴 때 threat model은 시스템을 직접 분석하고 이해하면서, 어디가 공격받을 수 있을지 상상해 가며 만들어 나갈 수밖에 없다.
오픈소스 쪽에서는 앞에서 말한 OSS Scanner가 threat model이 maintainer의 머릿속에만 있는 문제를 다루는 방식이 재밌다. 오픈소스 프로젝트가 신청하면 Anthropic의 가장 강한 모델로 주기적으로 무료 스캔을 해 주는데, 신청은 GitHub 저장소에 PR을 올리는 방식이고18 그 프로젝트의 핵심 maintainer만 할 수 있다. 이 PR에는 프로젝트를 빌드하는 Dockerfile이 들어가고, Anthropic은 threat model 파일도 같이 넣도록 강하게 권장한다.
threat model 파일이 없어도 동작은 하지만, 그때는 scanner가 애매한 부분을 추측해서 처리한다고 한다. 글을 쓸 당시 저장소가 열린 지 일주일이 지났는데, 등록 PR이 600개를 넘었고 등록된 82개 프로젝트 중 절반 넘게 threat_model.md를 같이 넣었다18.
scanner 같은 실제 제품도 앞의 prover처럼 범용(generalization)과 특화(specialization) 사이에서 고민하게 된다. 범용 scanner 하나로 모든 프로젝트를 잘 볼 수는 없고, 그렇다고 프로젝트마다 threat model과 환경을 우리가 다 만들 수도 없다. Anthropic은 그 부분을 개발자가 직접 넣게 했다. 엔진은 범용으로 두고, 환경과 threat model이라는 특화된 context는 그 프로젝트를 제일 잘 아는 사람에게 받는 것이다. 개발자가 직접 참여하게 만드는 똑똑한 방법인 것 같다.
사실 우리 팀도 5월부터 이런 방식을 고민했는데, 여러 이유로 실제로 실행하지는 못해서 약간 아쉽긴 하다.
사람의 손과 context를 어떻게 모을까
결국 문제는 context다. 빌드 방법, 위험한 입력, 보안 문제의 범위 같은 정보는 대부분 maintainer가 알고 있는데, maintainer는 이미 바쁘다. 이걸 써 달라고 하는 것도 그 사람의 시간을 쓰는 일이다.
AI로 찾은 제보가 늘어날수록, 프로젝트마다 방식을 맞추고 재현을 돕고 패치를 고치는 복잡한 일은 제보하는 쪽이 떠안아야 한다. 이 복잡함을 maintainer에게 넘기면 오픈소스 보안 연구는 계속될 수 없다. 이건 에이전트에게 일을 맡기면 판단은 누가 할까에서 쓴 사람 컨펌 bottleneck과 같은 이야기인 것 같다. 회사 안에서는 컨펌하는 사람이 우리 팀이고, 오픈소스에서는 maintainer다.
OpenAI와 Trail of Bits의 Patch the Planet이 바로 이렇게 제보하는 쪽이 복잡함을 떠안는 방식이다. Trail of Bits 보안 엔지니어들이 OpenAI의 보안 특화 모델로 버그를 찾고, maintainer에게 넘기기 전에 모든 finding을 직접 검토·검증하고, 중복을 묶고, 심각도를 다시 매긴다3. 그리고 제보만 하고 끝내는 게 아니라 패치와 테스트까지 만들어서 가져간다. 6월에 시작한 뒤 첫 주에만 PR 64개를 올렸고, 그중 37개가 이미 merge됐다19.
6월에 Linux Foundation이 시작한 Akrites도 같은 방향이다20. AWS, Anthropic, Google, Microsoft, OpenAI 같은 회사들이 각자 찾은 취약점을 공동 보안 대응팀(SIRT)에 모으면, SIRT가 중복을 합치고 심각도를 검증하고 공개 시점을 맞춘다. 같은 버그를 다섯 명에게서 다섯 가지 설명으로 받는 대신 maintainer는 정리된 창구 하나만 상대하면 되고, 고친 패치는 여전히 maintainer가 정한 방식대로 들어간다.
다시 Patch the Planet으로 돌아가면, Trail of Bits가 정리한 내용 중 흥미로운 건 false positive를 줄이는 데 가장 효과가 컸던 게 PyCA의 보안 문서21처럼 프로젝트가 직접 써 둔 threat model과 심각도 기준이었다는 점이다. 이런 가이드가 없으면 모델은 거의 모든 걸 critical로 매긴다고 한다19. 여기서도 context는 결국 maintainer에게서 나온다.
그래서 maintainer가 참여할 이유를 만드는 것도 중요하다. Anthropic은 무료 스캔과 maintainer용 Claude 구독을 주고2, Patch the Planet도 참여하는 프로젝트에 ChatGPT Pro와 API 크레딧을 준다3.
그래도 아직 질문이 많다. 모든 곳이 무료 스캔 같은 확실한 보상을 줄 수는 없다. 그런 보상 없이도 maintainer가 threat model을 쓰는 게 부담이 아니라 이득이 되게 하려면 어떻게 해야 할까? 여러 사람이 조금씩 가진 context를 어떻게 모아서 prover와 scanner에 넣을 수 있을까? 사람들이 보안 프로세스에 자연스럽게 참여하게 만드는 게 다음 과제인 것 같다.
Slop을 막을까, 다 받을까
앞에서 kernel 규칙을 보며, 높아진 bar가 오히려 좋은 버그까지 막는 건 아닐까 물었다. 그럼 제보를 받는 쪽은 어떻게 해야 할까? 요즘 분위기는 막는 쪽이다. 앞에서 말한 curl처럼 bug bounty를 아예 끝낸 곳도 있고, HackerOne의 Internet Bug Bounty는 3월에 AI로 찾은 제보를 오픈소스 쪽에서 고치는 속도가 따라가지 못한다며 새 제보를 멈췄다22. Chrome은 4월 말에 버그가 있다는 확실한 증거가 담긴 짧은 제보를 우대하도록 보상을 바꿨다. 바운티를 원하면 그만큼의 노력을 보여 달라는 것이다23. Google은 10월 1일부터 OSS VRP의 제품 취약점 제보도 잠시 받지 않기로 했는데, 자동으로 만들어진 제보가 크게 늘었지만 대부분이 유효하지 않았다는 이유다22.
한편으로는 이런 생각도 든다. 검증 시스템만 잘 만들어 두면, slop이라도 일단 들어오는 걸 다 받는 게 더 낫지 않을까? 들어오는 데이터를 쌓는 것 자체가 큰 자산일 수 있다. 그리고 그걸 검증하는 시스템을 개발 환경과 맞물려 돌리면 되지 않을까? 취약점을 찾는 쪽에서는 빌드 환경을 만드는 게 제일 어렵지만, 개발하는 쪽에는 이미 빌드 환경과 CI가 다 있다. 거기에 제보를 일종의 seed로 넣어서 비슷한 버그나 다른 취약점까지 찾게 할 수도 있다.
앞에서는 제보하는 쪽이 복잡함을 떠안아야 한다고 했지만, 받는 쪽에서 보면 얘기가 다르다. 나라면 정말 다 받을 것 같다. 내가 그 프로젝트의 개발자라면, context는 내가 제일 많이 가지고 있고, 빌드 환경도 이미 있고, 그 코드에 대해서는 내가 제일 전문가다. 그렇다면 밖에서 들어온 제보를 막기보다, 내 도메인 지식으로 직접 검증하는 게 훨씬 나을 것 같다. 그렇게 검증한 결과는 쓸모 있는 데이터 파이프라인으로 쓰고, 제보한 쪽에는 피드백을 주면서 어떻게 같이 개선할 수 있을지 고민해 보면 어떨까? 우리 팀이 Microsoft 블로그에 쓴 것도 같은 방향이다. 스캔 결과를 단순한 발견 목록이 아니라 다음 모델을 학습시키는 데이터로 보고, 검증 결과를 CI/CD와 개발 과정으로 다시 돌려보내야 한다고 했다10.
물론 다 받으면 그만큼 리소스가 든다. 쓸데없는 제보를 돌리느라 토큰과 CI 시간을 낭비하지 않게 우선순위를 정해야 하고, 바운티는 노력을 보여 준 제보에만 주는 식의 장치도 필요하다. 여러 방향이 있을 것 같다. 버그를 크라우드소싱하는 방식은 이제 정말 끝난 걸까, 아니면 받는 방식이 바뀌어야 하는 걸까?
다 검증하고 고칠까, 빨리 고치고 또 고칠까
제보를 받은 다음에는, 패치를 어떻게 적용할지에 대해서도 방향이 두 가지로 갈리는 것 같다.
하나는 지금처럼 모든 검증을 다 거치고 나서 패치를 조심스럽게 적용하는 방식이다. 안전하지만 느리다. 다른 하나는 AI가 이미 충분히 똑똑하다고 보고, 필요한 context를 잘 줘서 패치를 만들게 한 다음, 패치 품질은 테스트와 리뷰로 시스템적으로 확인하고, 그래도 문제가 생기면 바로 다음 패치를 적용하는 방식이다. 패치 사이클 자체를 최대한 짧게 만드는 것이다.
Anthropic은 에이전트가 빠르게 개발할 수 있게 받쳐 주는 시스템을 만들고 있다. Claude가 짜는 코드가 늘면서 하루 merge 수가 5월 약 2,500건에서 9월 3만 건 넘게 늘자, source control을 아예 새로 만들었다24. 사람 규모에 맞춘 merge queue 대신 merge 이후와 배포 전의 자동 테스트에 더 투자했고, 변경끼리 충돌이 나도 사람이 알아채기 전에 Claude가 고치는 경우가 많다고 한다. 보안 패치를 위해 만든 시스템은 아니지만, 이런 시스템이 있으면 두 번째 방식으로도 문제를 풀 수 있지 않을까?
리뷰 쪽에도 사례가 있다. Linux kernel에서는 Google이 만들어 Linux Foundation에 기부한 Sashiko25라는 AI 리뷰 도구가 거의 모든 kernel 패치에 돌고 있다고 한다6. 두 번째 방식에서 말한, 패치 품질을 리뷰로 시스템적으로 확인하는 쪽에 가까운 사례다.
테스트를 통과하면 맞는 패치일까
두 번째 방식은 패치 품질을 테스트로 확인한다고 했는데, 테스트를 통과한 패치가 정말 맞는 패치인지 AIxCC가 끝난 뒤 Team Atlanta에서 직접 확인해 봤다. 결승의 같은 취약점 63개를 올해 2월 기준 코딩 에이전트 10개 구성에게 패치하게 하고, 나온 패치 630개를 사람이 모두 검토했다26. 가장 좋은 구성은 45개 정도를 제대로 고쳤고, 작년에 같은 방식으로 평가한 Claude Code(Claude 3.7 Sonnet)의 33개보다 확실히 나아졌다. 그런데 빌드와 기존 테스트, crash 재현을 모두 통과한 패치 중에서도, 가장 좋은 구성에서 20% 정도, 다른 구성은 40%까지가 실제로는 틀린 패치였다. 정상 기능을 바꿔 버리거나, crash가 난 자리만 막고 원인은 그대로 두거나(off-by-one 계산을 고치는 대신 buffer를 키우는 식), 검사 조건이 너무 느슨한 경우가 많았다. 테스트로는 보이지 않고 사람이 직접 봐야 잡히는 실패다. 다만 여러 에이전트가 만든 패치 3개를 나란히 놓고 에이전트에게 하나를 고르게 하면, 가장 좋은 단일 에이전트와 같거나 더 나았다. 서로 다른 패치를 비교하면 원인을 제대로 고친 쪽이 눈에 띄기 때문인 것 같다.
물론 이건 그때 모델의 성능으로, context도 제대로 주지 않고 얻은 결과다. 그래도 실제로 쓸 수 있는 패치라면 취약점을 막고 기능 테스트를 통과하는 것만으로는 부족하다. 저장소의 코드 품질과 성능, 스타일뿐 아니라, 그동안 내린 결정과 그 이유, 커뮤니티가 합의한 방향까지 맞춰야 할 것 같다. 이런 정보를 잘 활용해서 정교한 패치를 만드는 것도 재밌는 연구 주제다.
두 번째 방식을 쓰려면 이런 걸 다 확인할 수 있는 패치 사이클 시스템이 정말 잘 되어 있어야 한다. 이걸 어떻게 만들 수 있을까? 큰 오픈소스 커뮤니티에서는 만들려는 움직임이 있지만, 아직 어느 정도까지 만들어졌는지는 잘 모르겠다. 그리고 maintainer 몇 명이 꾸려 가는 작은 오픈소스 프로젝트는 이 흐름을 따라가기 힘들 것 같다.
마치며
AI가 버그를 찾는 비용이 줄어든 만큼, 증명하고 고치고 설명하는 쪽이 더 중요해진 것 같다. 찾았다는 것만으로는 아무것도 고쳐지지 않는다. 그렇다면 그 사이를 메우는 건 아직 사람과, 사람이 만든 prover와 패치, 사람이 알려 준 context, 그리고 고친 결과를 빠르게 돌려 주는 패치 사이클이 아닐까?
3줄요약
- AI로 취약점 후보를 찾는 비용은 크게 줄었지만, 진짜 버그와 false positive가 섞여 쏟아지면서 재현, 분석, 패치, 제보의 부담이 커졌다. 테스트를 통과한 패치도 맞는 패치라는 보장은 없다.
- 후보는 반론, 중복 묶기, threat model 같은 싼 필터로 먼저 줄이고, 남은 것만 비싼 prover로 확인한다. prover에서 가장 어려운 건 AI가 아니라 실제와 같은 빌드와 실행 환경이다.
- threat model은 저장소 하나가 아니라 연결된 시스템 전체를 보고 판단해야 하고, 그 context는 maintainer에게서 나온다. 제보하는 쪽은 복잡함을 떠안아야 하지만, 받는 쪽 입장에선 slop이라도 일단 받아서 CI/CD 안에서 검증하는 게 낫지 않을까?
참고 자료
OpenAI, Patch the Planet: A Daybreak Initiative to Support Open Source Maintainers (2026-06-22) ↩︎ ↩︎2 ↩︎3
Daniel Stenberg, The End of the curl Bug-Bounty (2026-01-26) ↩︎
The Register, AI Bug Reports Went from Junk to Legit Overnight (2026-03-26) ↩︎ ↩︎2
Phoronix, Linux Kernel Adds Documentation for What Qualifies as a Security Bug, Responsible AI Use (2026-05-15) ↩︎
The Register, Linux Kernel Devs Drop Obligatory Confession of AI Tool Usage (2026-10-14) ↩︎
Microsoft, 3 Lessons from Frontier AI Vulnerability Research (2026-10-07) ↩︎ ↩︎2 ↩︎3 ↩︎4 ↩︎5
SoK: Enabling Security Analyses of Embedded Systems via Rehosting (AsiaCCS 2021) ↩︎
Windows, Evolving Windows Vulnerability Management to Meet the Speed of AI-Powered Discovery (2026-07-09) ↩︎
Trail of Bits, Introducing Patch the Planet (2026-06-22) ↩︎ ↩︎2
Linux Foundation, Linux Foundation and Industry Leaders Launch Akrites to Defend Critical Open Source Software Against AI-Enabled Cyber Threats (2026-06-25) ↩︎
SecurityWeek, Google Narrows Open Source Bug Bounty Amid Wave of Invalid Automated Reports (2026-10-05) ↩︎ ↩︎2
Google Bug Hunters, Evolving the Android & Chrome VRPs for the AI Era (2026-04-30) ↩︎
Anthropic, Redesigning Source Control at Anthropic (2026-10-13) ↩︎
Team Atlanta, Patching Vulnerabilities with Coding Agents in 2026 (2026-03-11) ↩︎